
 IXThinker·2025-03-08 18:10
32B小模型憑GRPO稱霸推理 訓練成本降百倍
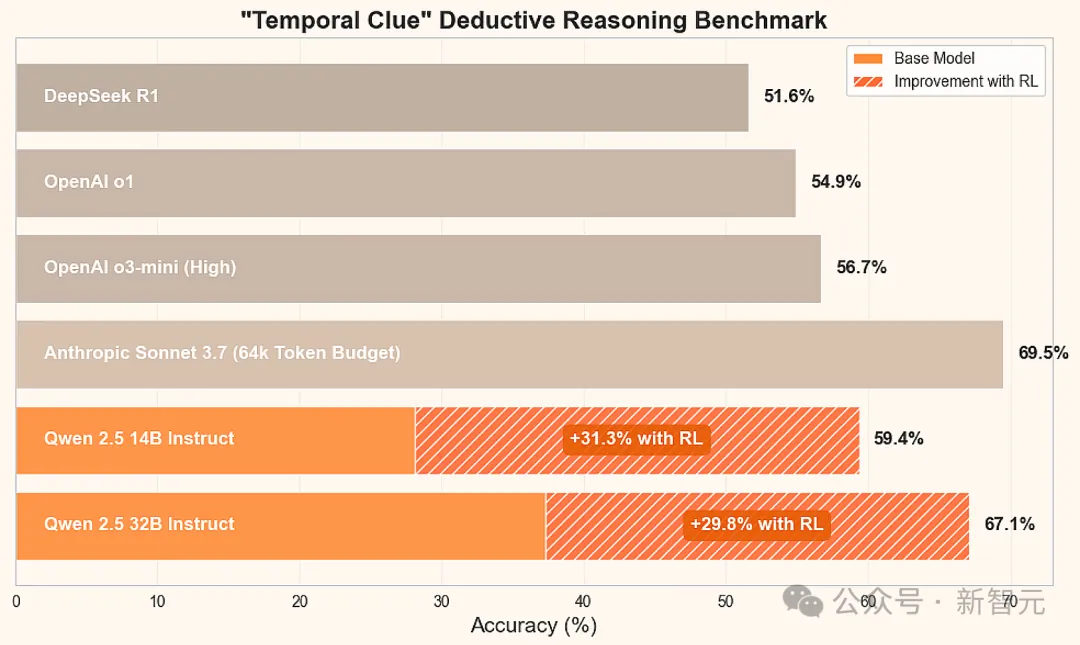
大不一定更強。研究人員用DeepSeek的核心算法GRPO對Qwen 2.5 32B進行強化學習微調,令這個小模型在超高難度的邏輯謎題上反勝多個頂級推理模型,訓練成本更大幅下降。
謎題設定
測試採用脫胎於經典桌遊Clue的「時間線索」(Temporal Clue)邏輯謎題,在原有玩法上加入時間等維度,對推理能力要求極高,被視為檢驗模型邏輯思維的硬核考題。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。