
 IXThinker·2025-04-01 10:00
OPPO 研究院聯手港科廣 提出多模態泛化推理技術
OPPO 研究院與港科廣科研人員提出 OThink-MR1,把強化學習擴展至多模態語言模型,以動態強化學習提升泛化推理能力,令多模態大模型更好地應對複雜任務與新場景。
現狀與短板
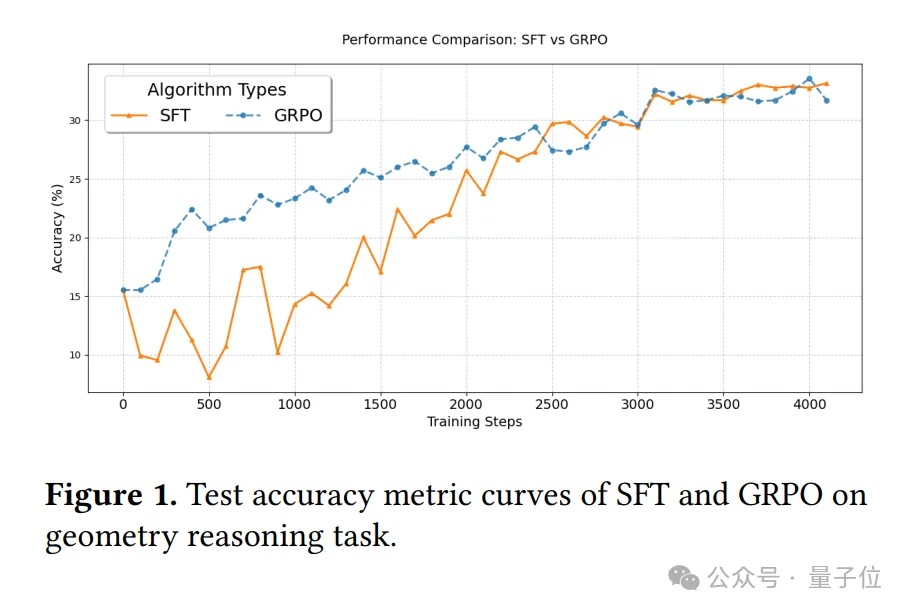
多模態大模型能處理多種輸入並生成輸出,但一遇複雜推理任務表現往往不佳。目前大多數模型訓練採用監督微調 SFT,如同老師劃重點讓學生按固定模式學習,特定任務表現不錯,卻難以培養關鍵的泛化能力。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。