
 IXThinker·2025-04-03 22:40
騰訊RLVR框架令7B獎勵模型覆蓋全學科
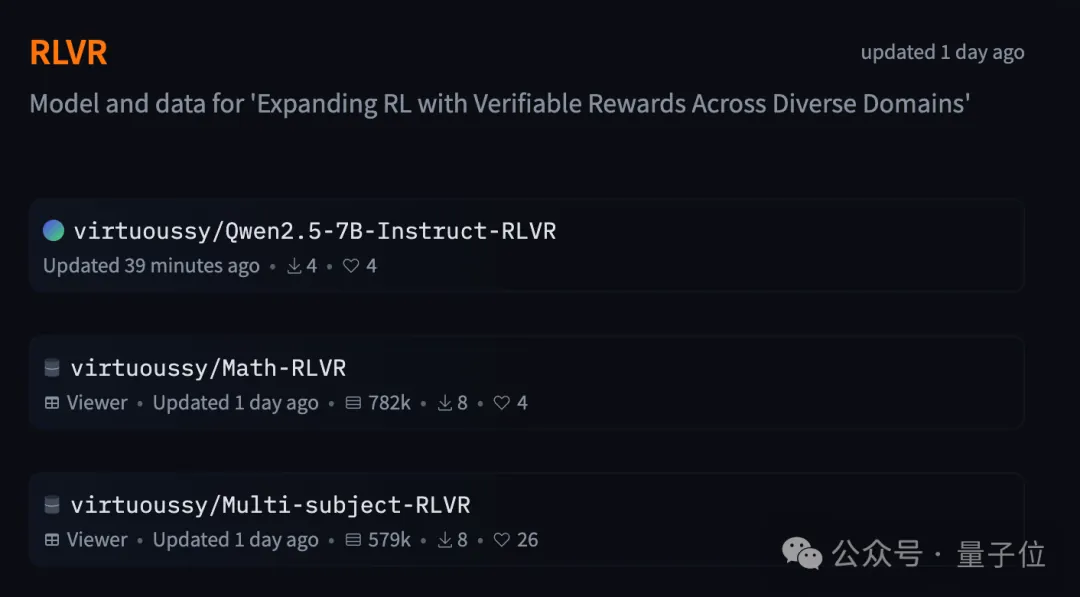
大模型強化學習不再局限於數學與代碼。騰訊聯同蘇州大學提出RLVR框架,把強化學習訓練擴展至醫學、法律、經濟等多學科,並開源7B獎勵模型與配套的多學科數據集。
為何偏重數理
o1、r1等模型展現的強化學習能力,過往主要在數學與代碼領域探索,因這兩類數據結構化程度高、答案客觀,獎勵函數或獎勵模型較易設計,其他學科長期缺乏類似條件。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。