
 IXThinker·2025-04-04 10:20
V²Flow對齊視覺Token實現高保真圖像生成
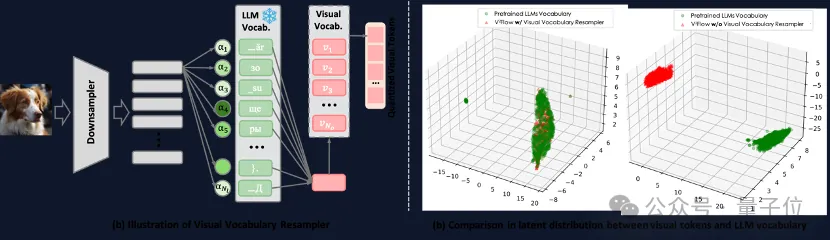
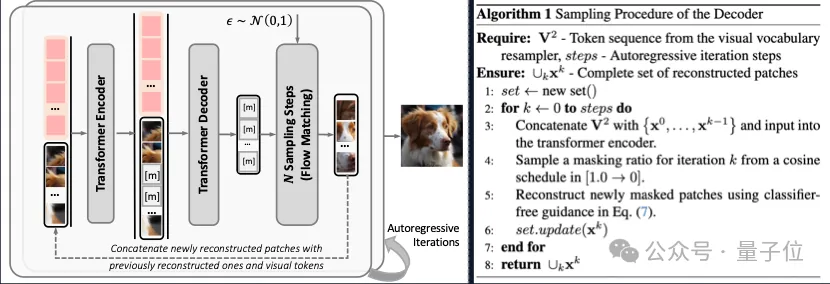
自回歸建模正從文本擴展到視覺生成。V²Flow框架實現視覺Token與LLMs詞表的無縫對齊,基於大語言模型完成高保真自回歸圖像生成,推動視覺與文本統一於同一預測範式。
統一預測範式
自ChatGPT掀起自回歸建模浪潮後,研究者嘗試把視覺與文本數據統一至「next-token prediction」框架。實現自回歸圖像生成的關鍵,在於設計向量量化的視覺tokenizer。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。