
 IXThinker·2025-04-09 00:00
智源伙南開大學開源兩大中文語音數據集
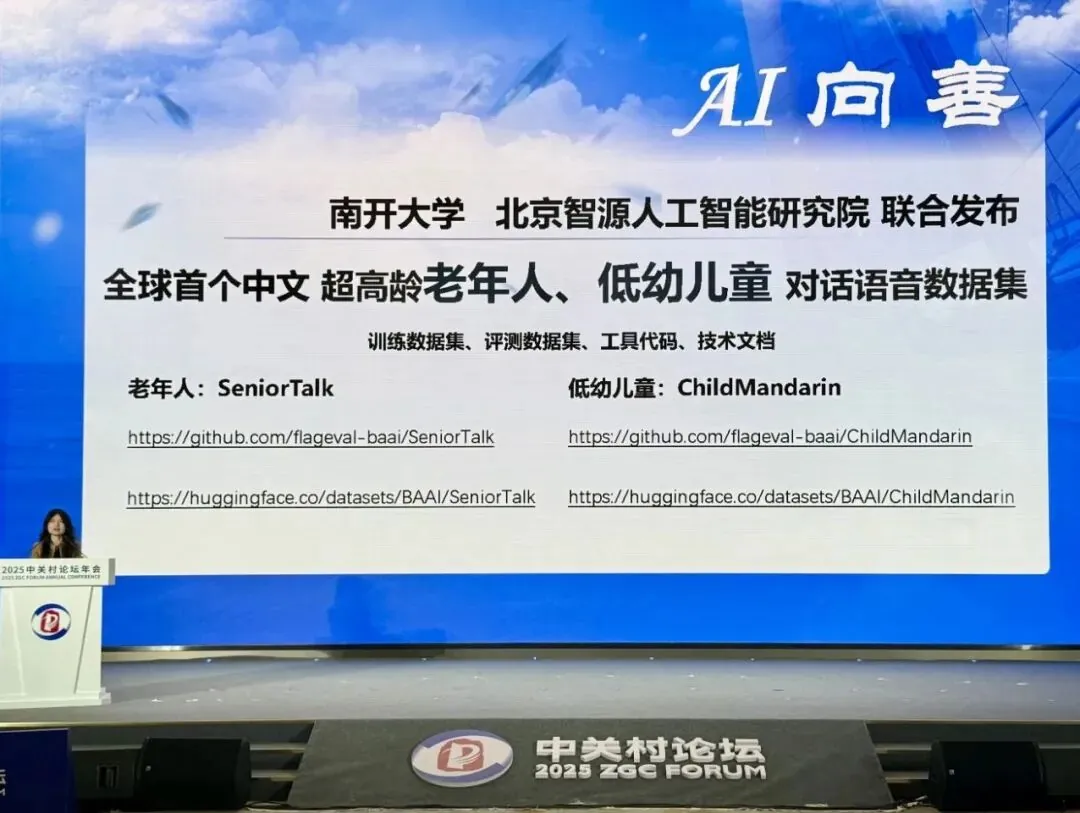
兒童與老年人佔人口超過三成,卻長期缺乏自然對話語音數據,智能語音技術難以照顧兩個群體。研究機構聯同南開大學HLT Lab發布並開源兩大中文語音數據集,填補老幼語音研究空白。
數據空白
低幼兒童與高齡長者主要依靠語音與智能設備交互,但其語音在音高、語速與發音清晰度上與成年人差異很大,現有模型普遍表現不佳。兩個群體的自然對話數據此前近乎空白,成為技術普惠的最大障礙。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。