
 IXThinker·2025-04-18 19:20
3700次預訓練實驗總結超參數縮放定律
大語言模型的高效訓練離不開精細的超參數優化。一項大規模實證研究透過3700次預訓練與網格搜索,總結出最優超參數縮放定律,並開源海量實驗數據,協助研究者告別盲猜式調參。
縮放定律現形
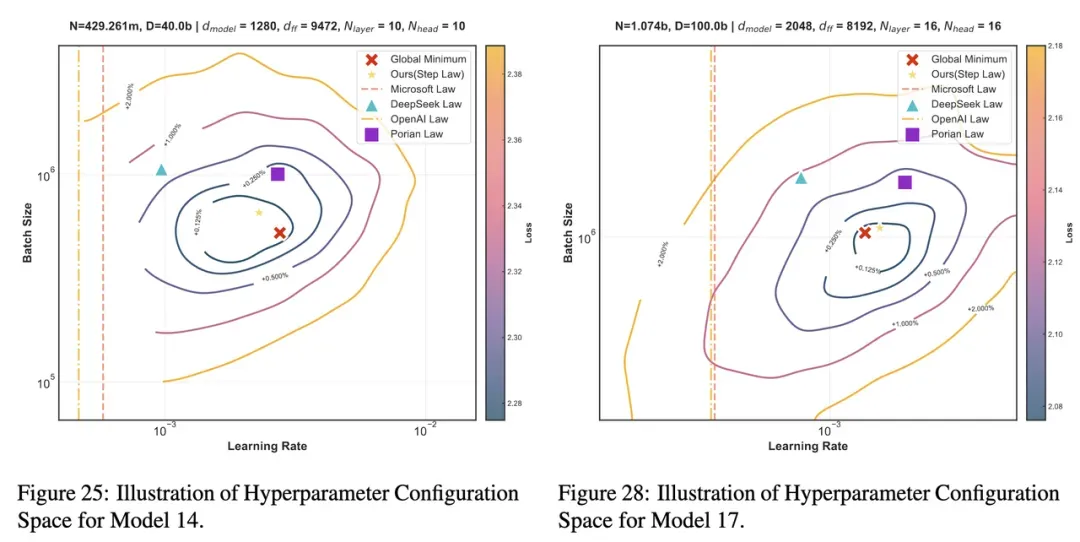
研究發現,最優學習率與模型參數規模及數據規模均呈冪律關係,最優批量大小則主要隨數據規模變化。這套最優超參數縮放定律,為不同規模的模型訓練提供通用指引。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。