
 IXThinker·2025-04-22 20:30
研究指強化學習難誘發新推理能力
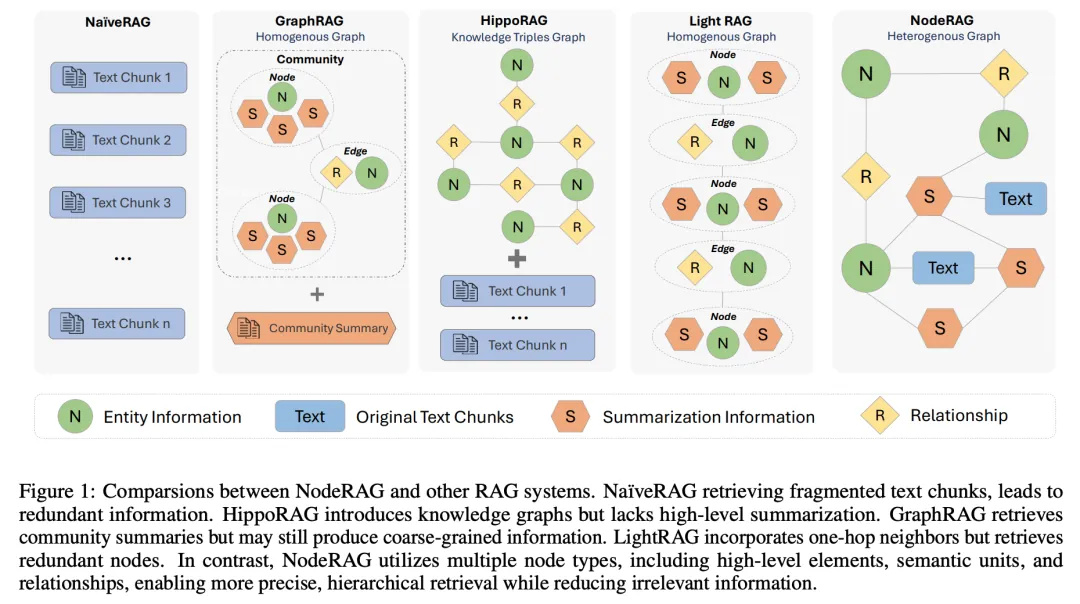
一週熱門論文盤點中,清華黃高團隊關於強化學習推理能力的質疑最受關注;另有圖形RAG新方案NodeRAG、降低測試時計算成本的「睡眠時計算」,以及Meta的感知編碼器等多項研究入選,覆蓋推理、生成與模擬等方向。
質疑RLVR
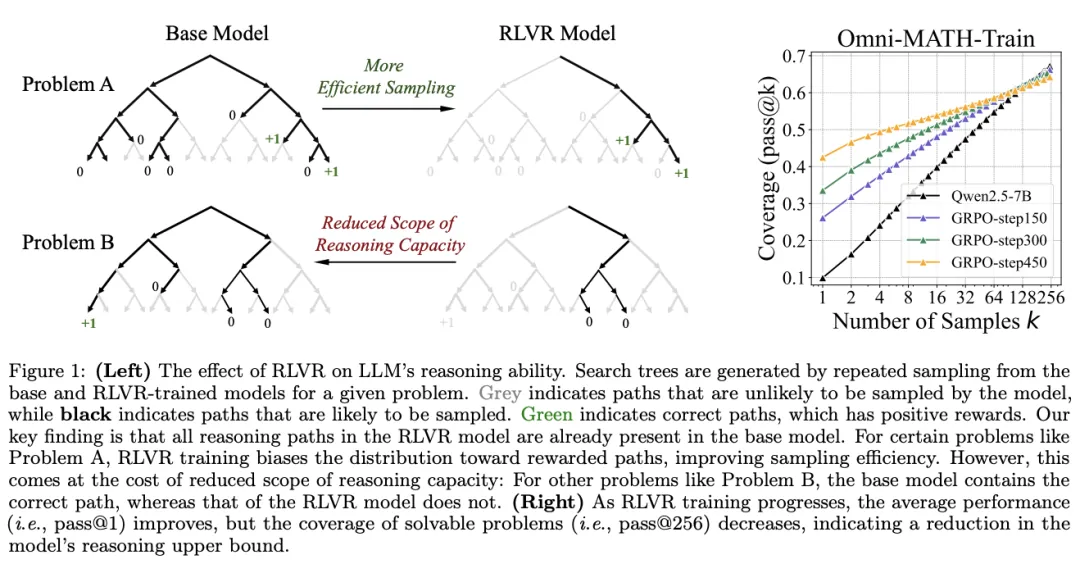
普遍觀點認為,基於可驗證獎勵的強化學習(RLVR)能推動大語言模型持續自我優化,從而在數學與編程任務中習得超出基礎模型能力的新型推理能力。黃高團隊的研究則對此提出質疑,指強化學習無法誘發真正新的推理能力。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。