
 IXThinker·2025-04-27 00:10
阿里高德開源GPG 重構強化學習訓練框架
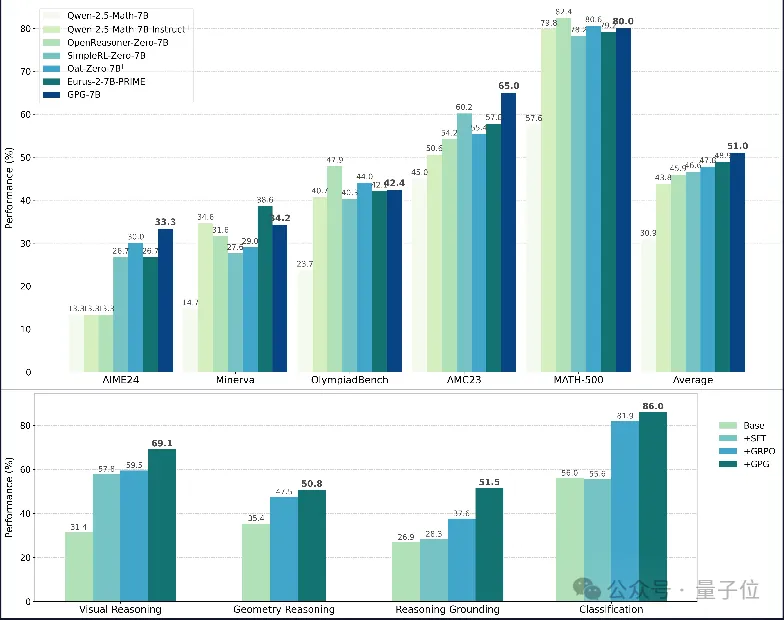
阿里高德地圖團隊提出並開源強化學習訓練新方法——組策略梯度優化GPG(Group Policy Gradient)。該方法從底層重構訓練框架,僅優化原始目標,大幅簡化流程之餘提升穩定性與性能,實驗中在單模態與多模態兩類任務上均表現領先。
設計思路
GPG拋棄替代損失函數,僅優化原始目標,開創性地從底層重構強化學習訓練框架。方法同時消除critic與reference模型,避免KL散度約束,令整體架構極簡、訓練流程更直接,也更容易工程落地。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。