
 IXThinker·2025-05-12 22:30
RM-Bench首個獎勵模型評測基準面世
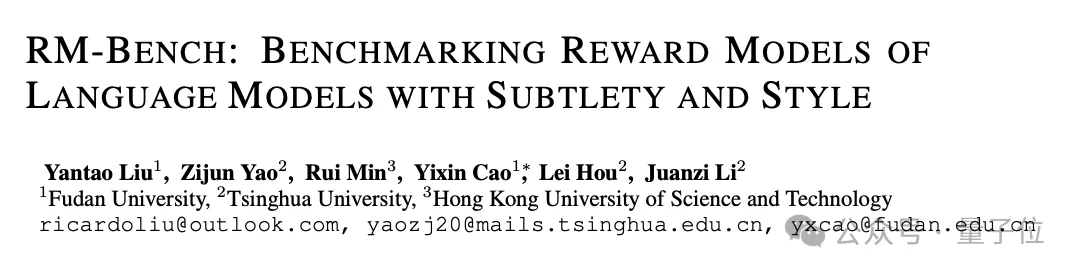
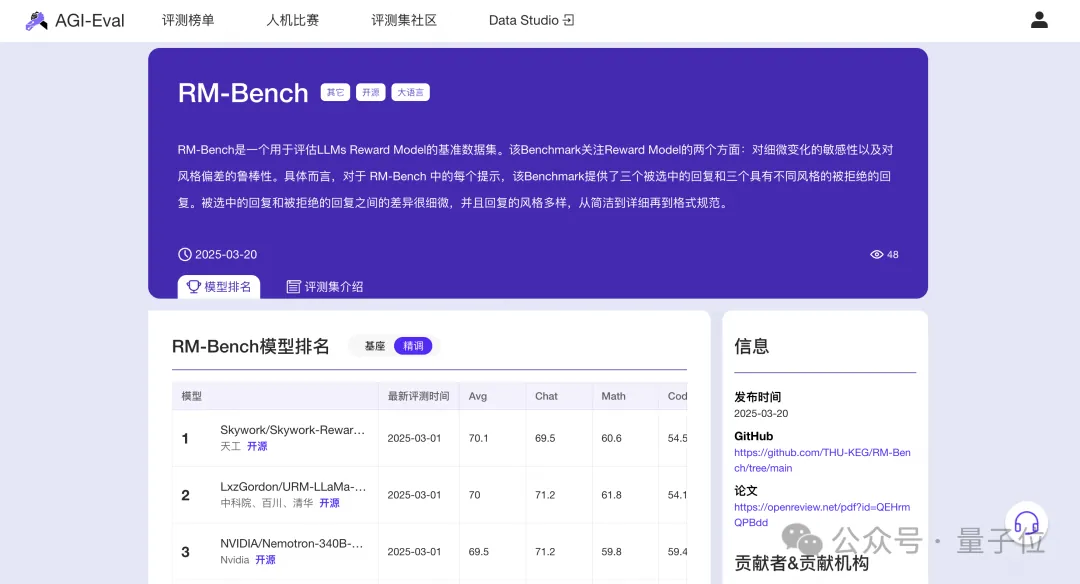
獎勵模型是大語言模型對齊的關鍵,卻長期困於「形式大於內容」的困境:論證胡亂如「1+1=3」也可能不被識破。清華、復旦與港科大團隊發布RM-BENCH,首次系統性為獎勵模型本身建立評測基準。
AI評委偏科
部分模型會出現胡亂論證的情況,例如把「1+1=3」說得頭頭是道,評測系統卻渾然不覺甚至予以肯定,反映獎勵模型對內容質素的判斷能力有待改進。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。