
 IXThinker·2025-05-21 20:00
思維鏈非萬能 研究指CoT或損指令遵循
DeepSeek-R1帶動推理模型熱潮,「越會思考越可靠」幾成共識。然而哈佛大學、亞馬遜與紐約大學的合作研究潑出一盆冷水:思維鏈(CoT)可能分散模型注意力,令其偏離用戶指令,推理能力與可控性之間的張力值得業界正視。
熱潮下的反思
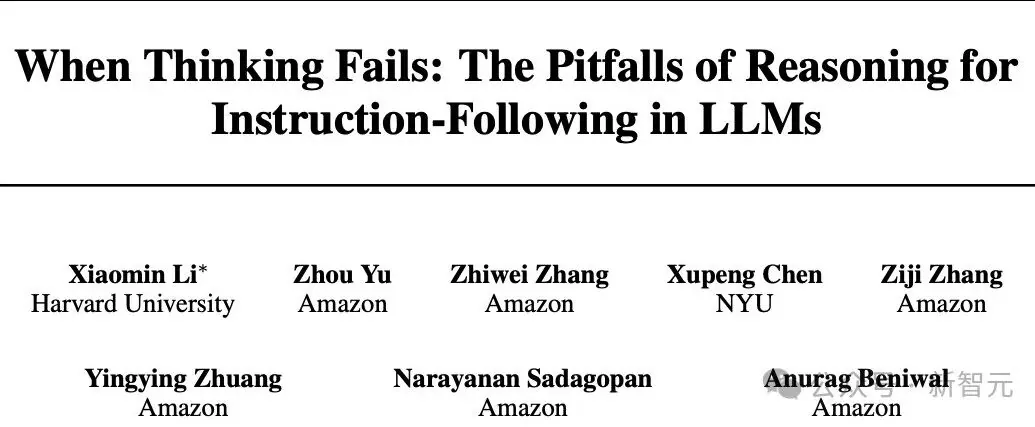
DeepSeek-R1引爆LLM推理革命後,「推理能力越強、模型越好」幾成共識,思維鏈(Chain-of-Thought)亦隨之普及。然而來自哈佛大學、亞馬遜及紐約大學的研究團隊提出異見:CoT有時令模型越想越錯,並非總是錦上添花。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。