
 IXThinker·2025-06-08 22:00
20萬次模擬實驗:大模型多輪對話表現遜單輪
ChatGPT 將大模型推進「對話」場景,用戶習慣先提粗略問題再逐步補充細節。然而最新研究以大規模實驗揭示:多輪對話的表現,其實明顯遜於單輪對話。
20萬次實驗
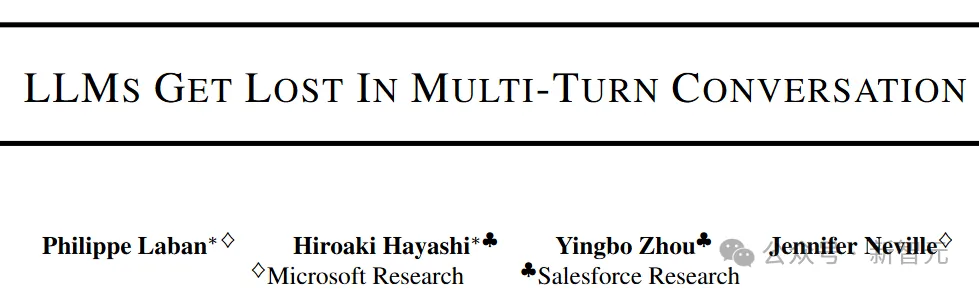
研究人員進行超過20萬次模擬實驗,耗資5000美元,系統比較大模型在單輪與多輪對話下的表現,證實多輪場景成績明顯較差。現有評測基準大多基於單輪機制設計,輸入指令更長、資訊更完善,與真實情境有落差。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。