
 IXThinker·2025-06-11 20:20
新基準拷問Agent:頂尖模型成功率僅40%
北大鄧小鐵課題組等提出新基準IDA-Bench,模擬真實數據分析中「邊想邊改」的多輪交互場景。測試顯示,即使Claude-3.7與Gemini-2.5 Pro等頂尖模型,任務成功率最高僅得40%。
考察什麼
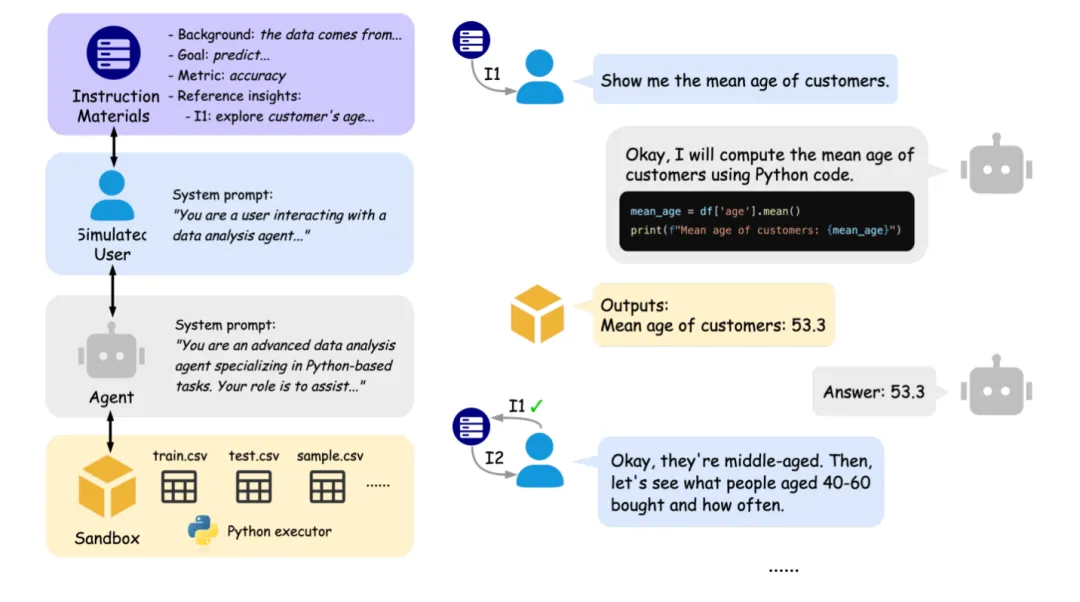
IDA-Bench不再是讓模型一口氣算完一道題,而是模擬一位真實數據分析師,在對話中不斷下達新指令,考察Agent能否在多輪交互中按用戶想法靈活調整分析步驟。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。