
 IXThinker·2025-06-11 19:10
調整SFT數據配比緩解大模型偏科
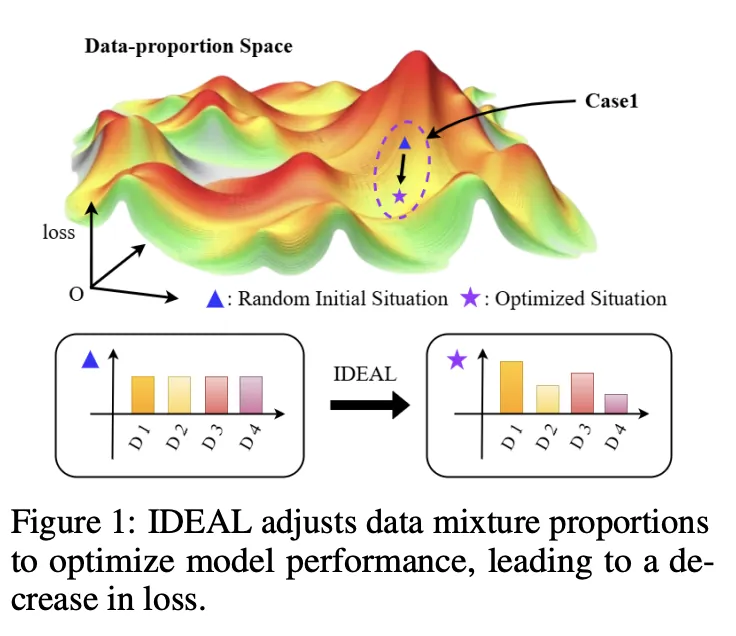
上海交大與上海AI Lab等組成的IDEAL團隊提出新方法,只需調整SFT訓練集組成,便能大幅緩解大語言模型的「偏科」問題,原本不擅長編碼的Llama 3.1-8B代碼能力明顯提升。
偏科現象
LLM經SFT後常出現部分能力不升反跌的情況。研究發現,SFT階段訓練數據的數量並非關鍵,配比不合適時,訓練數據越多,模型「偏科」反而越嚴重。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。