
 IXThinker·2025-06-13 18:40
大型推理模型能力天花板仍待釐清
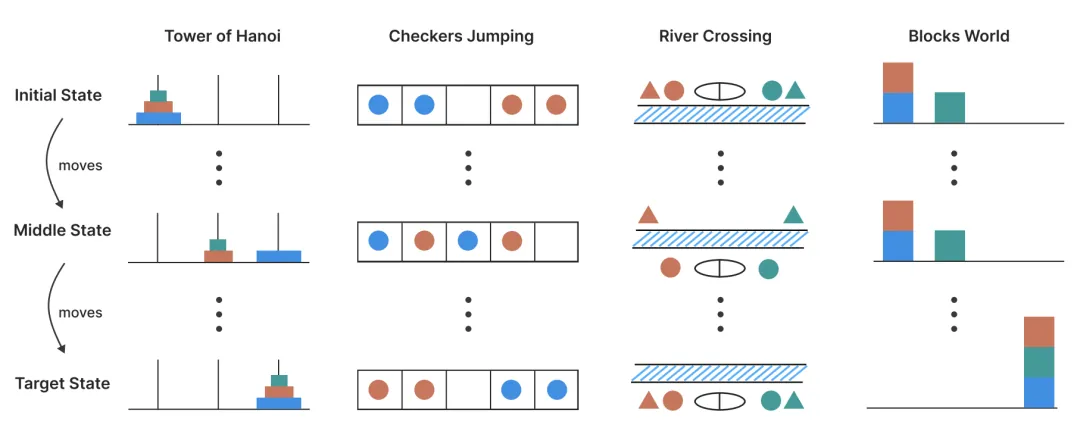
新一代大型推理模型(LRM)會在給出最終答案前生成詳盡思考過程,在各項推理基準上表現大幅躍升,但其基本能力、規模化特性與內在局限仍未被充分理解。有研究以可控謎題環境系統性填補這些認知空白。
評估範式缺陷
目前對LRM的評估主要聚焦既有的數學及編碼基準,強調最終答案準確率。這種範式容易受數據污染影響,亦無法深入剖析推理痕跡(reasoning traces)的結構與質量,限制了我們對模型推理機制的全面認知。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。