
 IXThinker·2025-06-24 21:00
新RL算法CPGD訓純數學 跨域推理勝o1
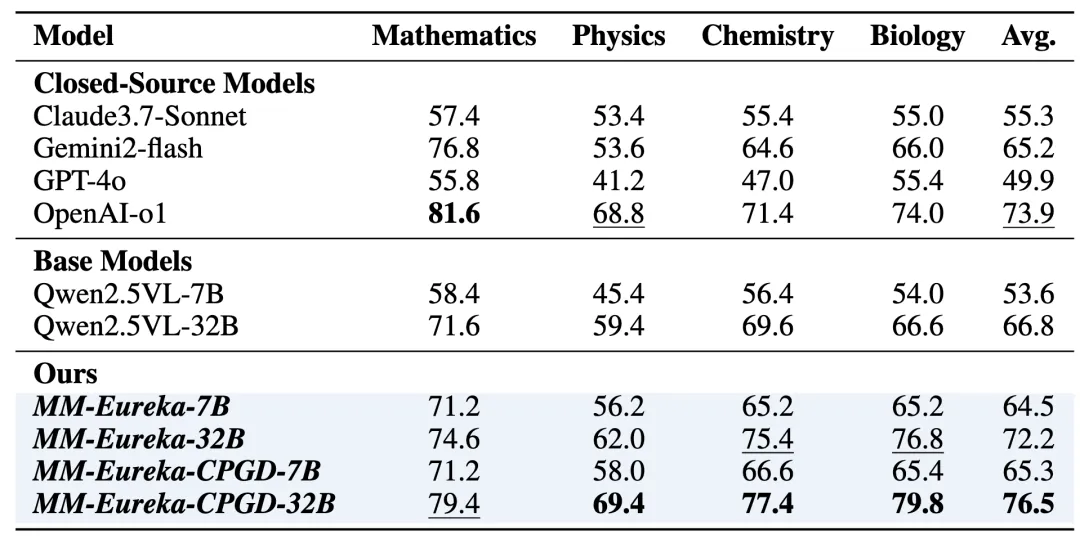
只用數學數據訓練,卻在物理、化學、生物等基準上戰勝o1——上海創智學院與上海AI Lab的MM-Eureka系列工作,以新強化學習算法CPGD再次驗證RL對推理能力的提升作用。
算法創新
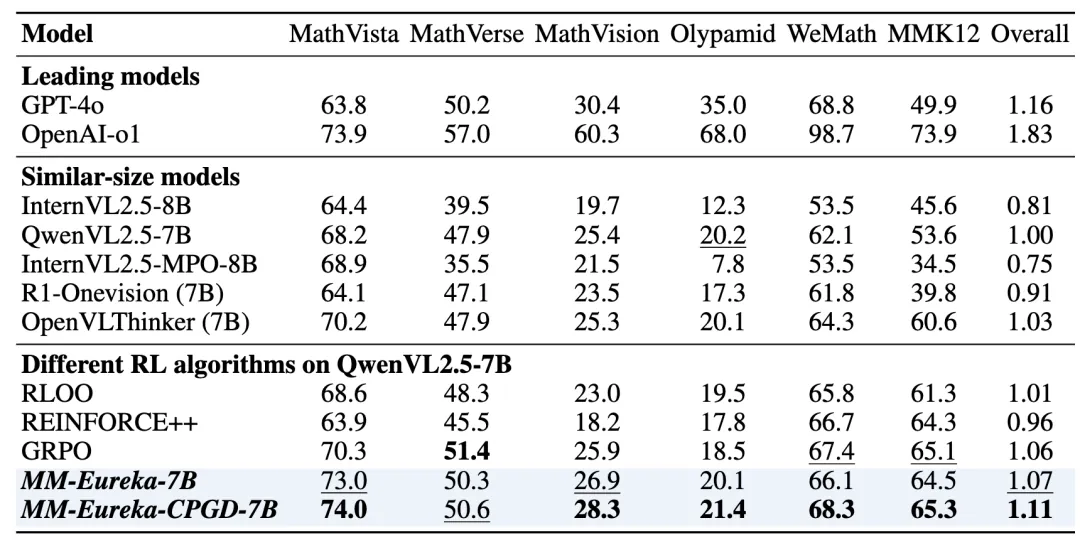
CPGD全稱為Clipped Policy Gradient Optimization with Policy Drift,相比GRPO、RLOO等傳統算法,明顯緩解了訓練不穩定甚至崩潰的問題,讓強化學習過程更平穩可控。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。