
 IXThinker·2025-07-02 16:10
L-Zero僅靠RLVR訓練 讓大模型自學探索世界
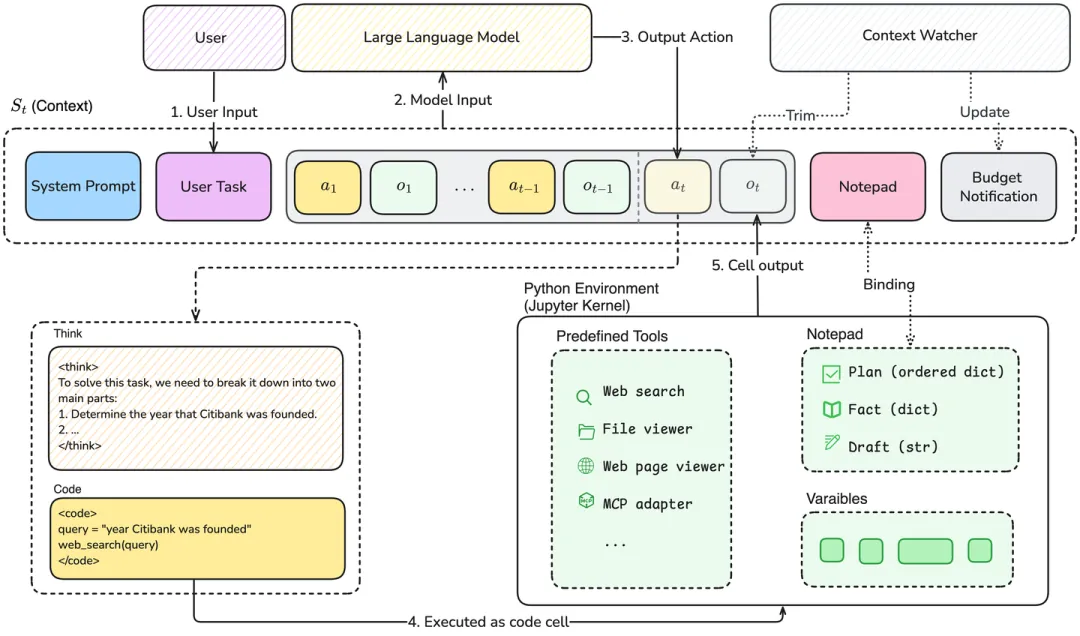
招商局獅子山人工智能實驗室提出基於RLVR的端到端Agent訓練系統,令大模型無需人類調教,即自主進化出探索、驗證與記憶能力,性能提升84%至166%,推動AI向真正「自學成才」邁進。
現狀瓶頸
當前主流的LLM Agent高度依賴提示詞工程、複雜的系統編排,甚至靜態規則表,令它們面對複雜任務時難以實現真正的智能行為演化,通用性始終受限。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。