
 IXThinker·2025-07-18 15:00
多角色同框對話影片生成新框架 免剪輯直出
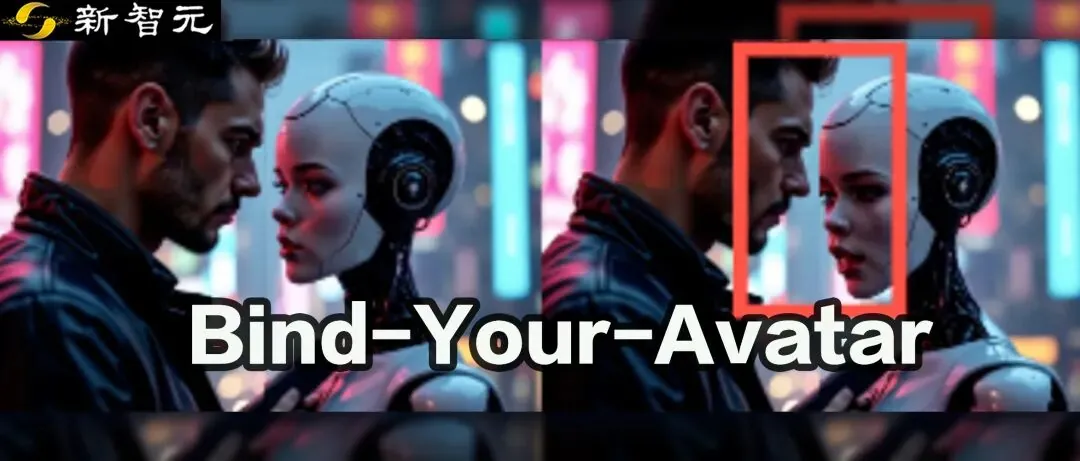
音頻驅動的說話人影片生成近年進展顯著,但現有方法多聚焦單角色場景。研究人員提出Bind-Your-Avatar框架,首度專注同場景多角色說話影片生成,透過細粒度路由實現語音與角色的精準綁定,免剪輯直出對話影片。
細粒度嵌入路由
Bind-Your-Avatar基於擴散Transformer(MM-DiT),透過細粒度嵌入路由,將每段語音與對應角色綁定。針對現有雙角色方法只能分別生成兩段分離說話影片的局限,它實現了同場景多角色的精準音畫同步。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。