
 IXThinker·2025-07-21 11:40
任務級獎勵訓練法強化App智能體
現有App智能體多依賴動作級獎勵訓練,只能預測每一步的最佳單一動作,難以適應不斷變化的流動環境。淘天集團未來生活實驗室聯同點淘演算法團隊提出Mobile-R1,以任務級獎勵結合多回合學習,提升智能體的適應與探索能力。
動作級獎勵的限制
現有Mobile/App智能體多依賴動作級獎勵(SFT或RL),只能引導模型預測每一步中最佳的單一動作,面對不斷變化的流動環境便難以招架。例如一句多步驟指令,Qwen2.5-VL-3B-Instruct在第二步便告失敗。
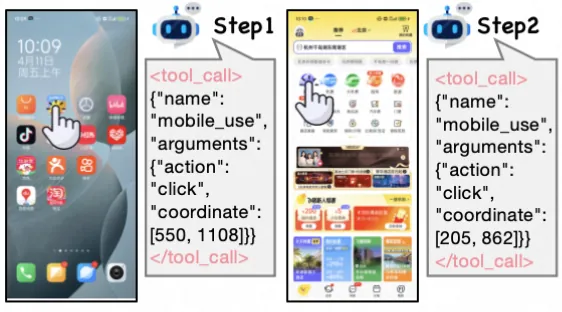
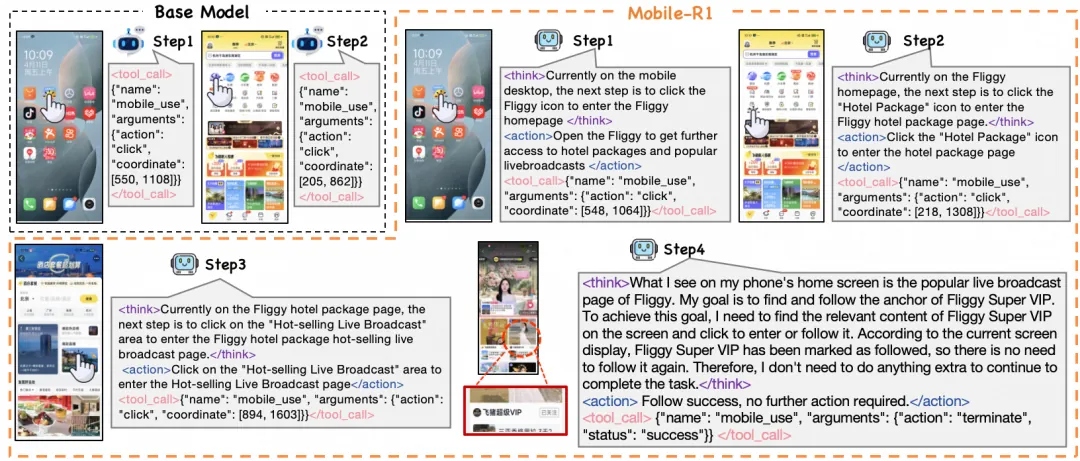
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。