
 IXThinker·2025-08-06 11:10
監督學習未死 新法20倍效率提升模型推理
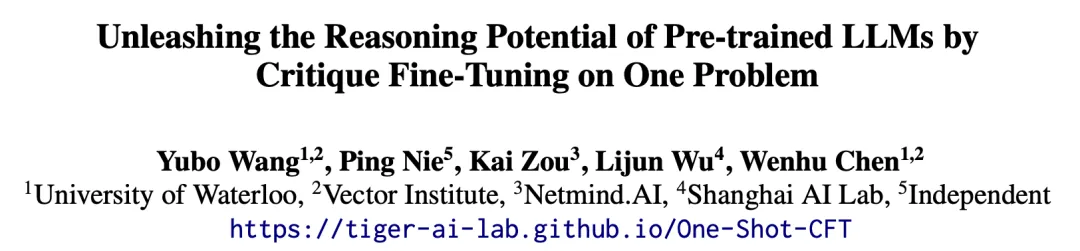
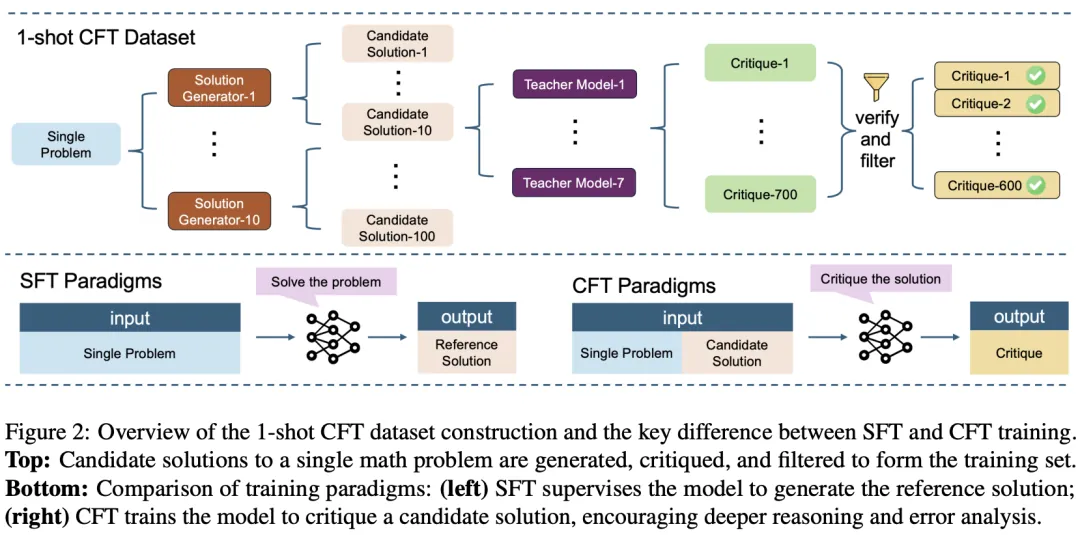
一題強化學習展現潛力,但即使只用一個樣本,RL訓練往往也需上百小時A100算力,且過程不穩、難以復現。有華人學者團隊另闢蹊徑,提出以監督學習為基礎的新方法One-Shot CFT,據稱訓練效率提升約20倍。
技術背景
大模型推理研究中,可驗證獎勵強化學習(RLVR)屢有突破,「一題強化學習」在多個任務表現亮眼。然而其算力成本高昂、訓練高度不穩定;傳統監督式微調(SFT)計算負擔雖小,低數據量下卻極易過擬合。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。