
 IXThinker·2025-08-08 04:10
主動學習新法 微調數據需求可減達萬倍
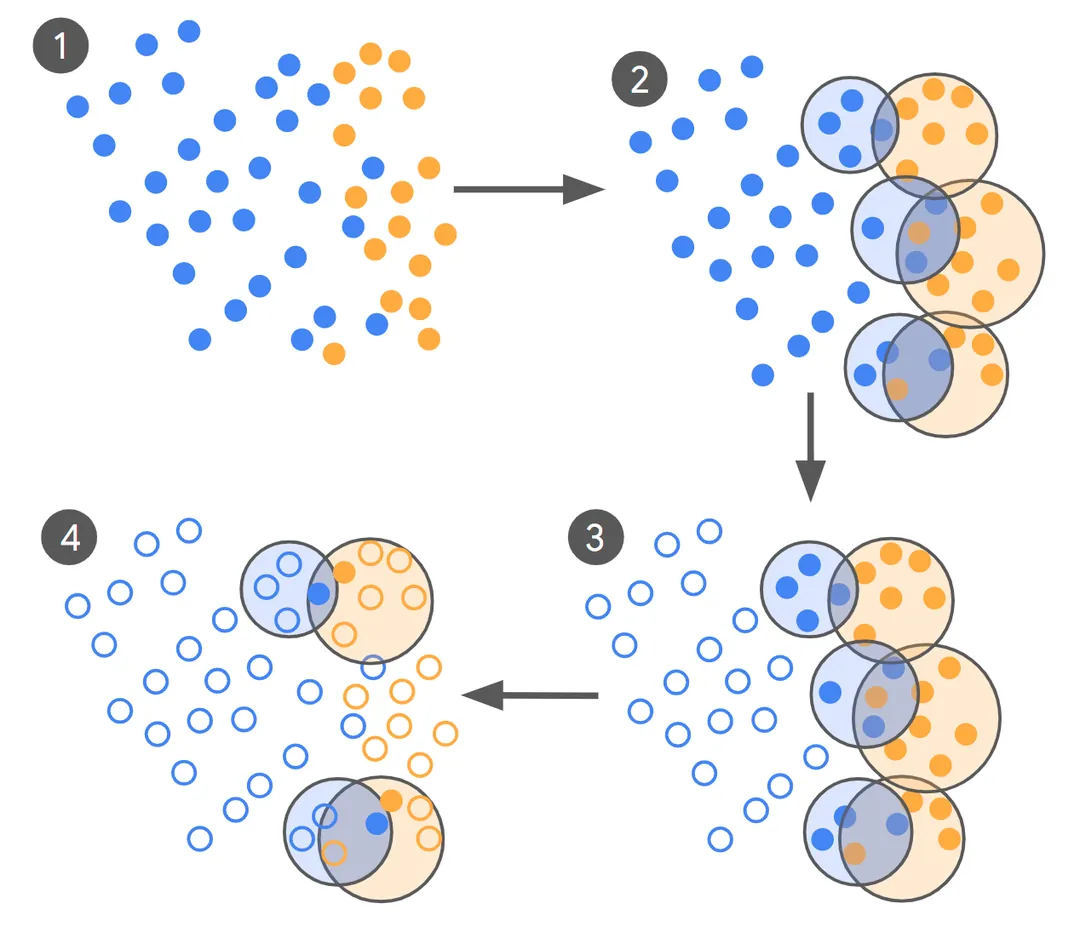
微調大語言模型往往需要大量高質素標註數據,成本高昂。一項新研究提出以主動學習篩選高保真標註數據的方法,大幅降低訓練數據需求,同時保住模型表現,為企業級應用降本提效。
問題背景
在識別違規廣告內容這類複雜任務上,大語言模型展現出比傳統機器學習更強的理解能力。然而高質素訓練數據的獲取成本高昂,且安全策略經常變動,會帶來概念漂移問題,令數據維護負擔沉重。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。