
 IXThinker·2025-08-15 11:50
研究指擴散語言模型數據潛力勝自回歸三倍
高質量訓練數據逼近枯竭,「token危機」成為大模型發展的隱憂。一項新研究提出,擴散語言模型可能是數據效率更高的出路,其數據潛力可達自回歸模型三倍以上。
擴散模型善學
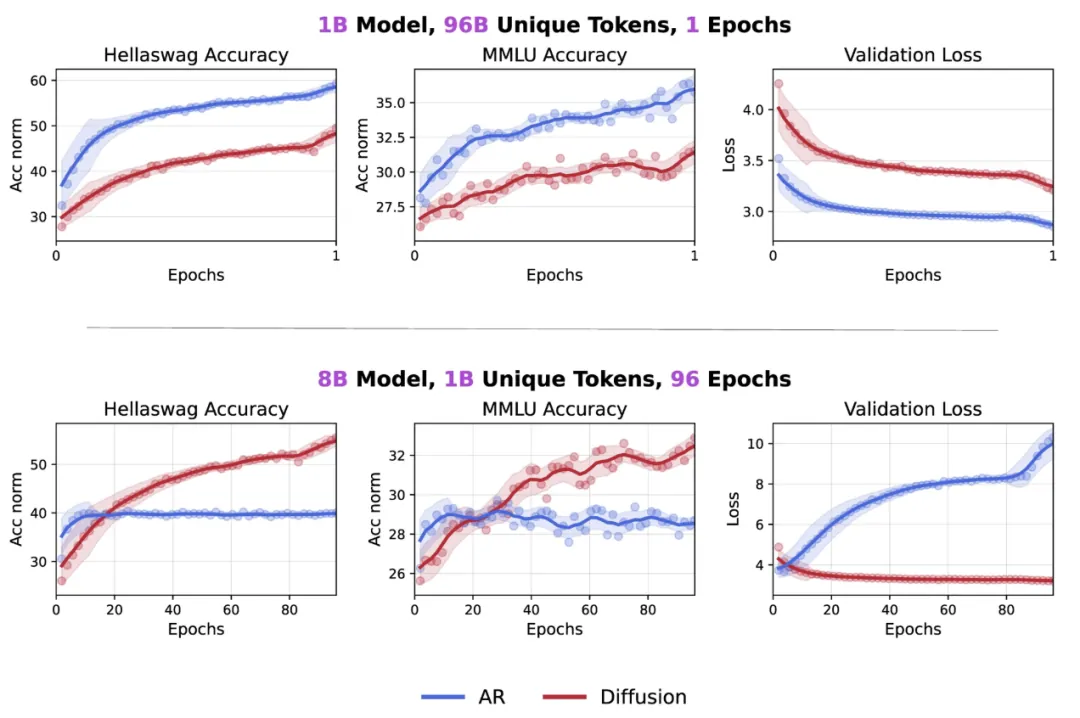
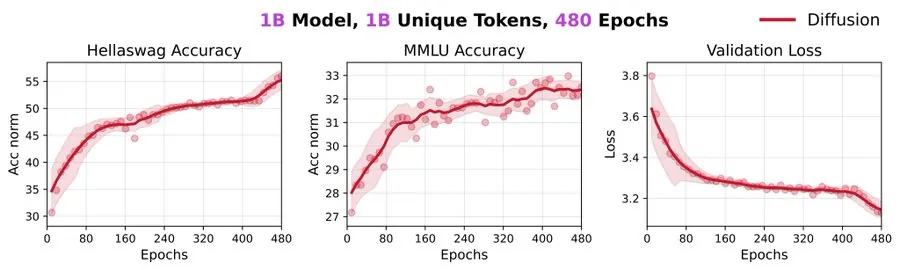
研究指出,在token數量受限的情況下,擴散語言模型可從同一批數據反覆學習,數據潛力達自回歸模型的三倍多,顯示其作為「數據學習者」的獨特優勢。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。