
 IXThinker·2025-08-18 12:20
研究揭LLM當裁判缺陷 先要認出誰在說話
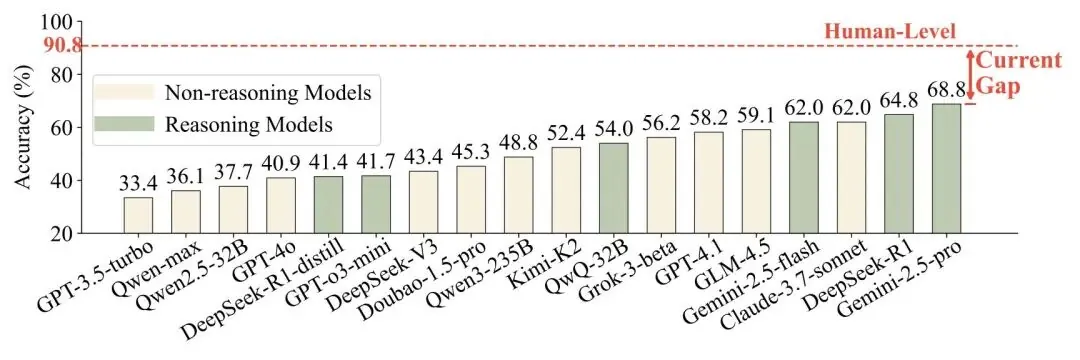
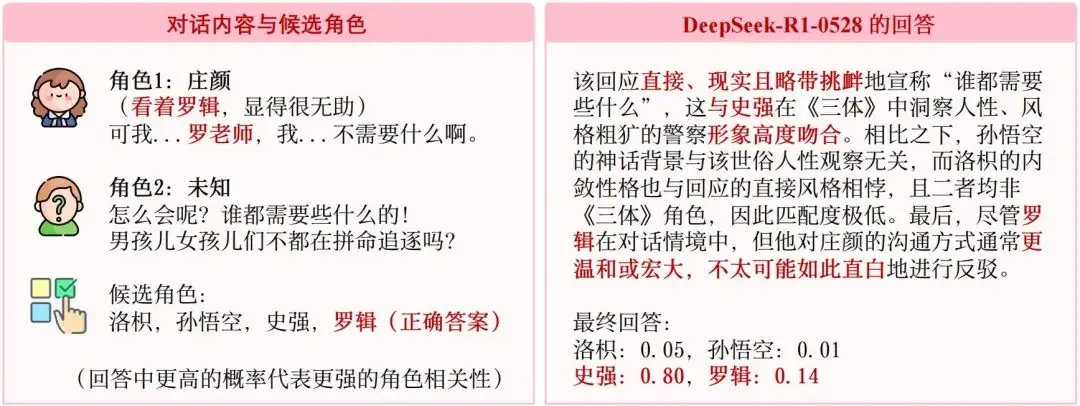
上海交通大學王德泉課題組發表論文PersonaEval,系統檢驗大語言模型擔當「裁判」評估AI生成內容的可靠性,聚焦一個基礎問題:AI能否準確辨認對話中誰在說話。
AI裁判興起
大語言模型正從工具進化為「裁判」(LLM-as-a-judge),大規模評判AI自己生成的內容。這種高效評估範式與人類判斷的一致性,卻很少被深入驗證,埋下隱憂。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。