
 IXThinker·2025-09-12 21:00
美團新研究出手 治大模型「過度思考」
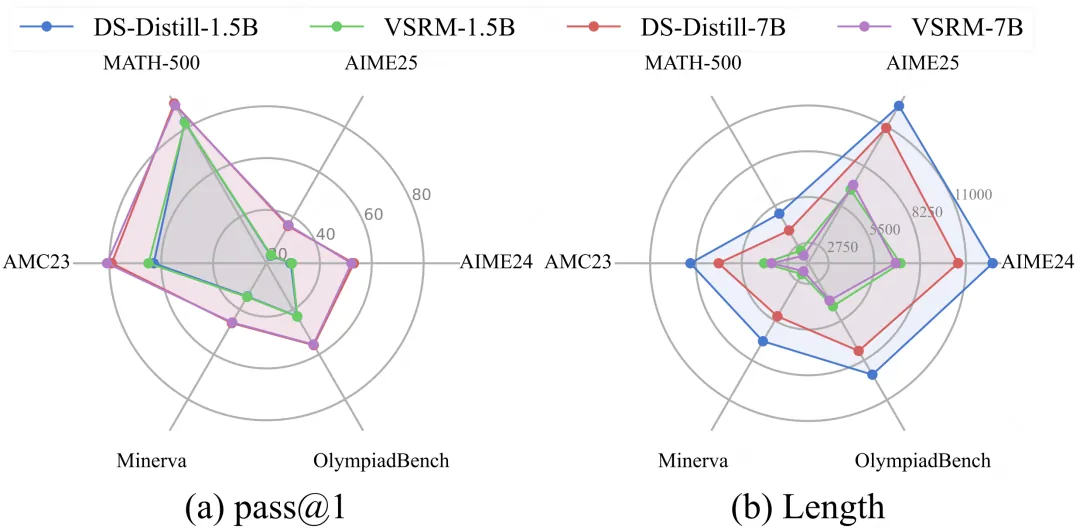
美團搜推團隊提出可驗證過程獎勵機制VSRM,針對推理模型的「過度思考」問題,在保持性能的同時大幅縮短輸出長度,提升推理效率與服務體驗。
過度思考之弊
推理模型透過強化學習培養出強大的思維鏈能力,但代價是輸出冗長:不僅顯著增加推理開銷,還拖累服務吞吐量、消磨用戶耐性。這種現象被稱為「過度思考」問題。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。