
 IXThinker·2025-09-19 17:10
論文週報:強化學習推理研究全景
強化學習(RL)已成為將大語言模型轉化為推理語言模型(LRM)的核心方法。清華大學聯合上海人工智能實驗室等機構發表系統綜述,梳理DeepSeek-R1發布以來該方向的最新進展與基礎性挑戰。
推理能力的新引擎
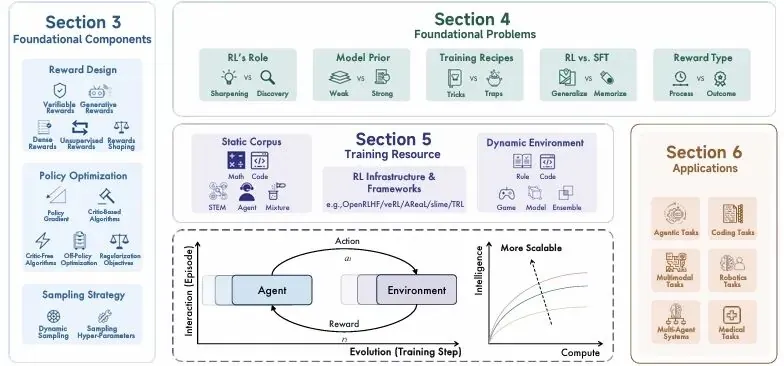
近年來,強化學習在推動大語言模型能力邊界方面成果顯著,逐漸成為構建推理語言模型的核心方法。自DeepSeek-R1發布以來,相關研究快速湧現,該綜述聚焦RL在LLM與LRM中的架構設計與關鍵挑戰,系統分析其研究圖景。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。