
 IXThinker·2025-09-29 13:50
陳丹琦新法RLMT 8B小模型勝GPT-4o
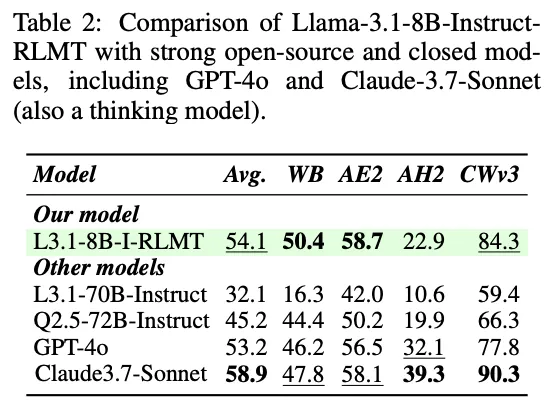
陳丹琦團隊再推新方法RLMT(基於模型獎勵思維的強化學習),結合RLHF與RLVR優點,要求模型作答前先思考,令8B小模型在多項任務上超越GPT-4o、媲美Claude-3.7-Sonnet。
方法機制
RLMT要求模型在回答之前先生成思維鏈,然後使用人類偏好訓練的獎勵模型來評價輸出,把RLHF的偏好建模與RLVR的思考習慣結合起來,開闢大模型強化學習的第三條路。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。