
 IXThinker·2025-09-29 11:50
杜克團隊DPad免訓練 擴散模型提速61倍
運算量與性能正相關,是大模型優化的慣常認知,杜克大學陳怡然團隊的新研究卻提出反例:擴散大語言模型主動減少運算,反而又快又準。新策略DPad毋須訓練即可挑出關鍵token。
反直覺發現
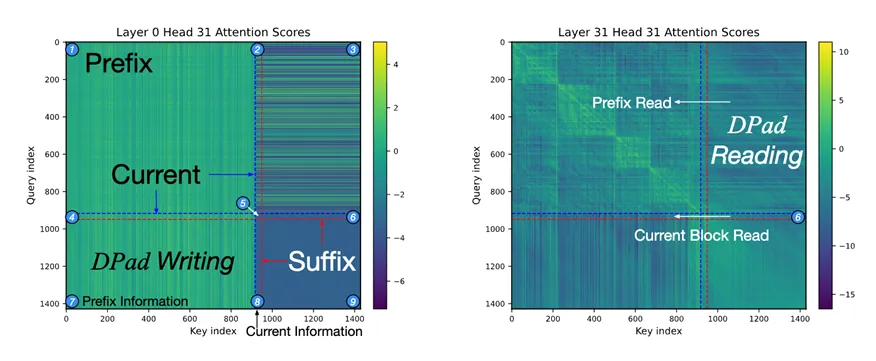
團隊發現,對於擴散大語言模型(dLLMs),只需關注少數如同「中獎彩票」的關鍵token,就能在推理時大幅提速,加速可達61倍至97倍,同時令模型更懂得格式、更聽從指令。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。