
 IXThinker·2025-10-18 16:04
早期經驗範式 讓智能體擺脫專家數據依賴
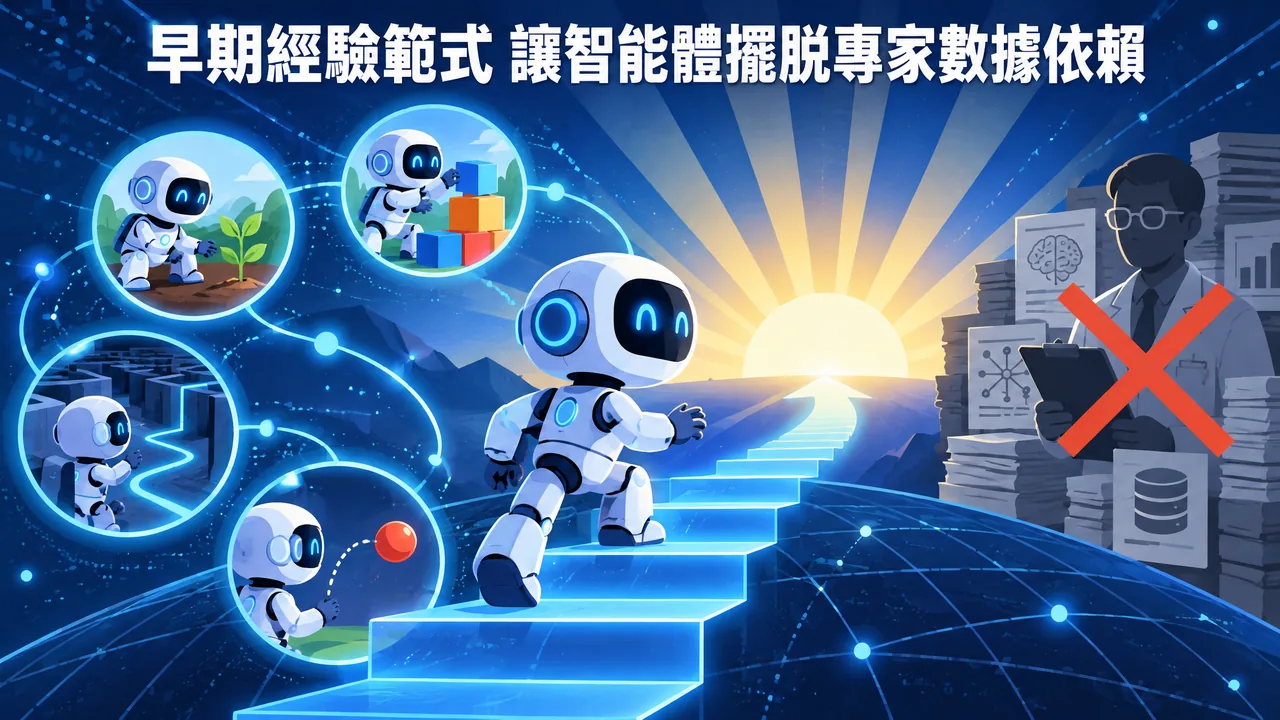
語言智能體的長期目標是憑自身經驗持續學習,最終在複雜真實任務中超越人類。Meta超級智能實驗室、Meta FAIR與俄亥俄州立大學提出「早期經驗」範式,讓智能體無需獎勵信號也能從交互中學習。
現有訓練困境
許多環境缺乏可驗證的獎勵信號,如網頁交互;或需要低效的長時程軌跡回放,如多輪工具使用,令純經驗數據加強化學習的訓練面臨巨大挑戰。因此當前大多數智能體仍依賴專家數據的監督微調,但這種方法難以擴展且泛化能力差。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。