
 IXThinker·2025-10-20 21:00
Meta開源DepthLM VLM不改架構懂3D深度
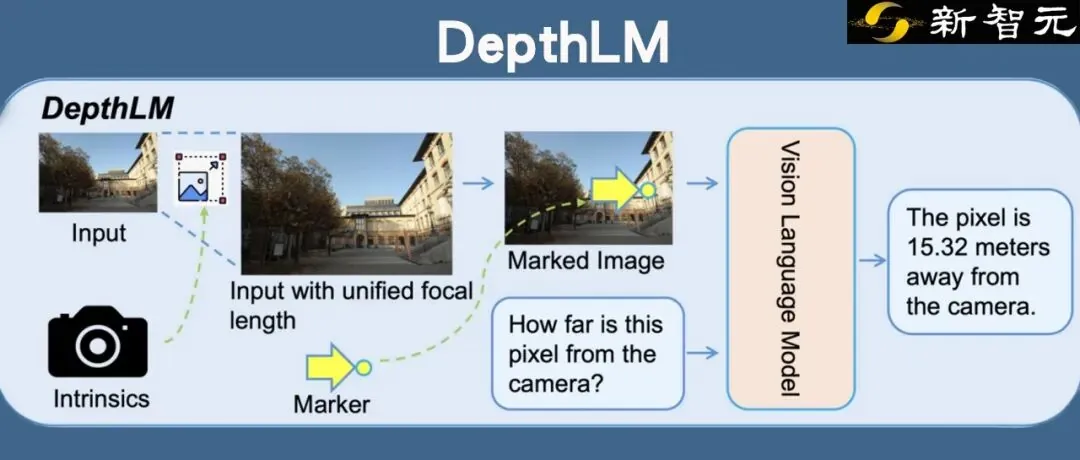
視覺語言模型擅長「看圖加文字對話」,但從二維圖像理解三維空間結構一直是弱項。Meta開源的DepthLM首次證明,毋須改動VLM標準架構也能實現媲美純視覺模型的3D理解能力。
VLM的3D短板
視覺語言模型在語義理解、視覺問答、圖像指令等任務上表現優異,然而在從2D圖像推斷3D空間結構方面明顯薄弱,以往往往要依靠改動架構的純視覺模型才能勝任深度估計。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。