
 IXThinker·2025-11-12 22:30
NeurIPS唯一滿分論文挑戰強化學習熱潮
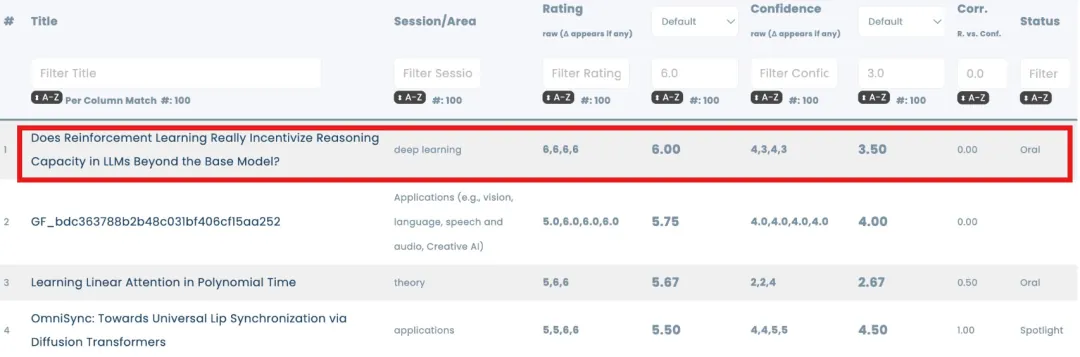
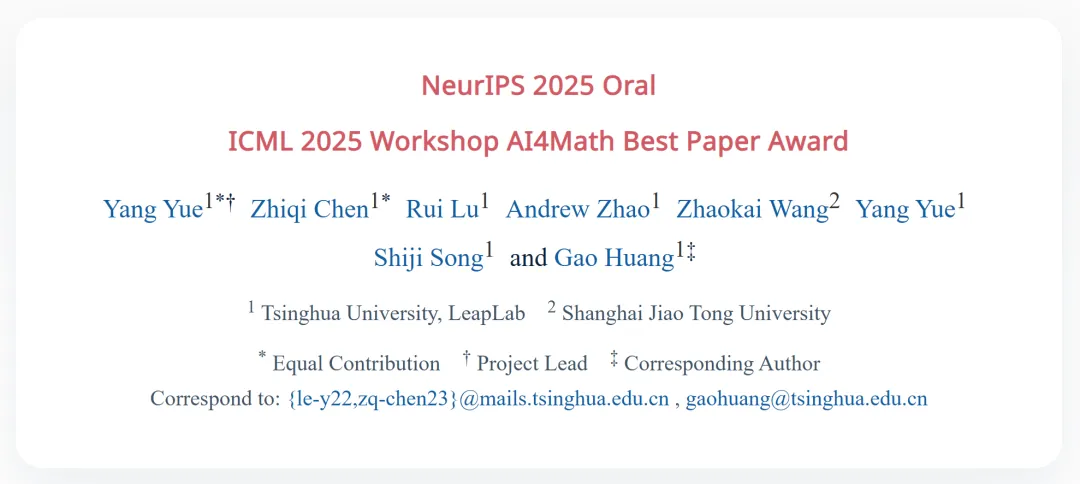
一篇獲四位審稿人全數給出6分、成為NeurIPS唯一滿分論文的研究近日廣受討論,其結論直指強化學習並非決定推理上限的關鍵,對當紅的RLVR路線構成直接挑戰。
出人意料的結論
論文指出,真正決定模型推理上限的是基座模型本身而非強化學習,且蒸餾比強化學習更有望實現大模型自我進化。這一判斷與主流認知明顯相左,因而被形容為向RLVR潑冷水。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。