
 IXThinker·2025-12-02 14:40
聯通HiMo-CLIP破長文本圖像檢索難題
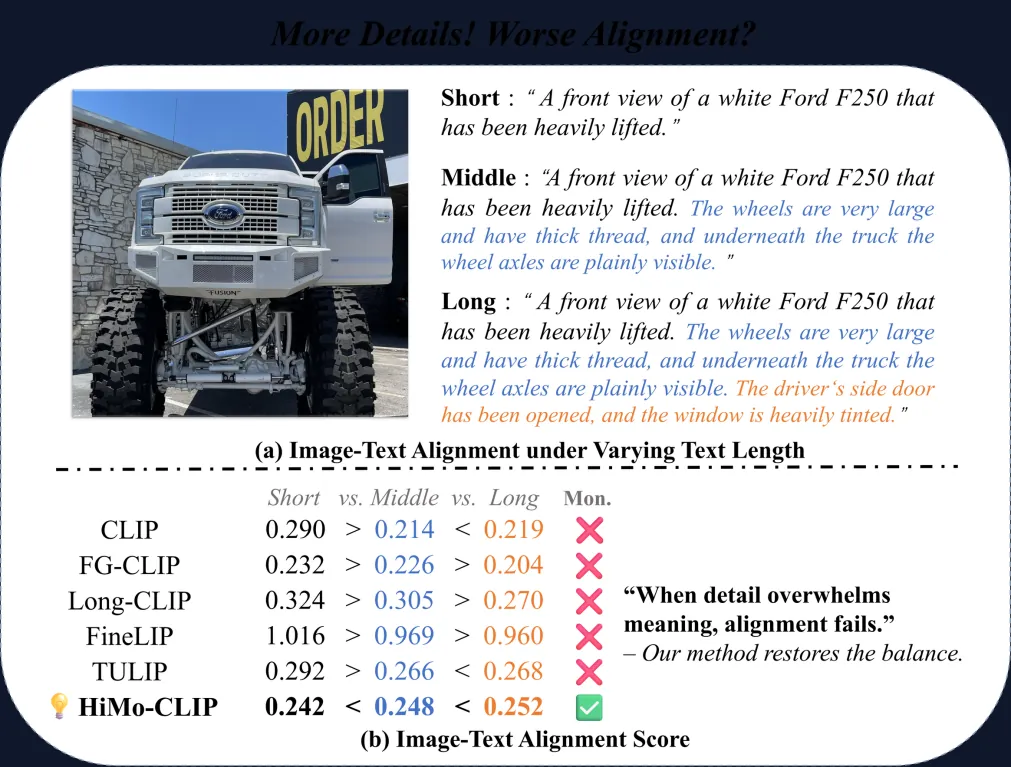
描述得越詳細,圖文匹配分數就應越高——這是常識,現有CLIP模型卻做不到。中國聯通研究院團隊的HiMo-CLIP研究成果入選AAAI 2026口頭報告,突破了這一局限。
CLIP的盲點
現有CLIP模型在長文本圖像檢索上存在結構化問題:描述愈詳細,匹配分數未必愈高,與常識相悖。視覺—語言對齊長期忽視這一痛點,制約了多模態檢索的精度。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。