
 IXThinker·2025-12-09 15:00
CoVT讓視覺模型畫出思考過程
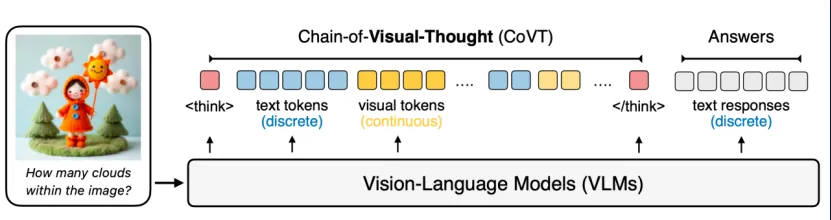
視覺語言模型在語言空間的推理表現出色,卻常常「看不細」。北京大學研究者提出Chain-of-Visual-Thought框架,引入連續視覺token,讓模型的視覺思維「畫」出來。
現有模型短板
視覺語言模型(VLM)在語言空間中的推理表現卓越,但在密集視覺理解方面有所不足;這一局限源於當前模型跨空間維度捕捉大量視覺資訊的能力有限,制約細粒度感知。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。