
 IXThinker·2025-12-09 12:40
LongVT破解長影片理解幻覺難題
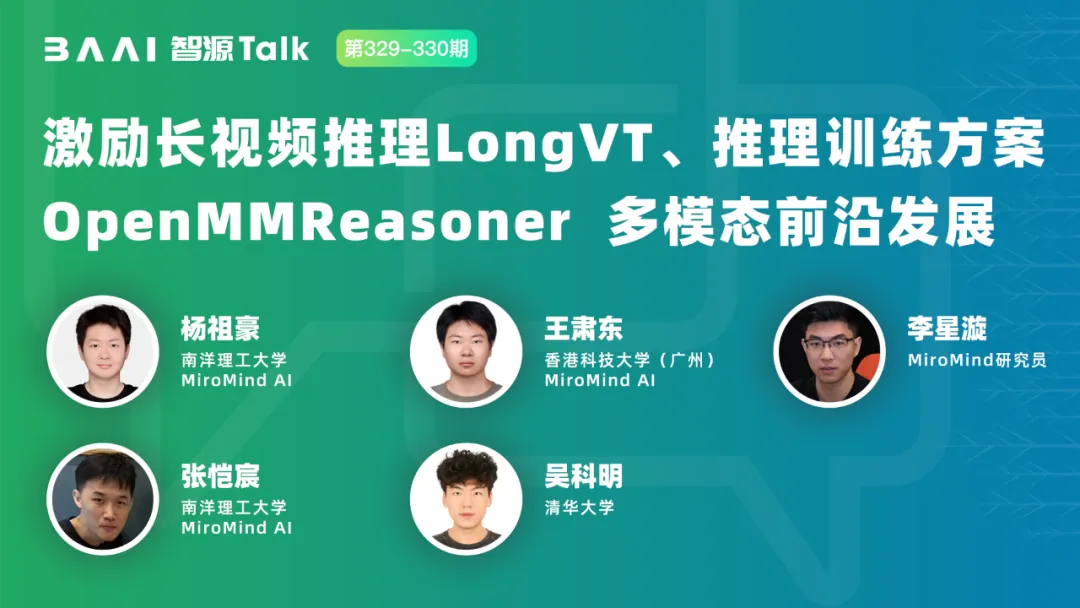
長影片理解一直受制於證據稀疏與幻覺兩大難題。即將在智源研討會分享的LongVT模型,嘗試讓模型像人一樣主動翻找畫面證據,而非被動接收全部影片訊息。
兩大核心痛點
傳統模型在長影片中難以定位關鍵證據,且容易產生幻覺;被動接收全部資訊的處理範式,令推理準確性與上下文連貫性都受到明顯制約。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。