
 IXThinker·2026-01-07 15:14
首個原生音頻基準出爐 大模型語音集體失手
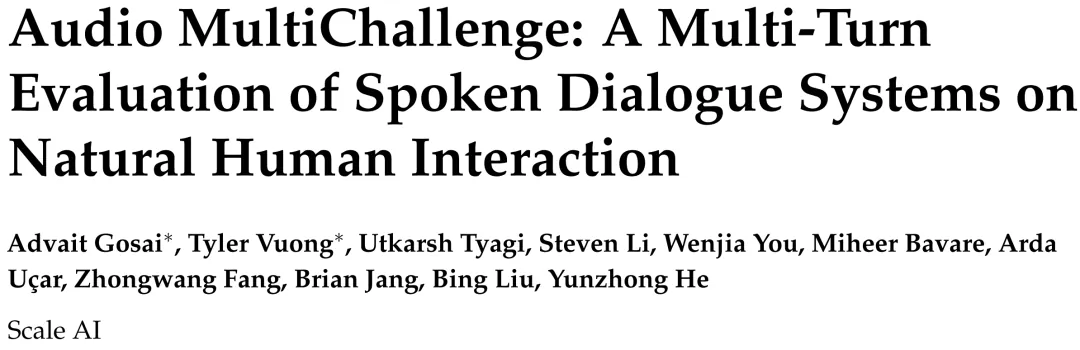
Scale AI發布首個原生音頻多輪對話基準Audio MultiChallenge,測試結果顯示大模型在真實人聲場景的表現遠遜文本領域:Gemini 3 Pro通過率僅過半,GPT-4o Audio表現更差。
合成語音的假象
隨着實時語音模型普及,外界一度以為AI已跨越自然交互的門檻。但過往評測多依賴合成語音,模型在語音對話中顯現的「聰明」,很大程度上源於評測手段的滯後。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。