
 IXThinker·2026-03-04 17:00
二次嘗試加反思蒸餾複雜任務提升81%
強化學習已成大模型後訓練的核心方法,但現實環境中獎勵信號稀疏且延遲,模型難以據此調整行為。新的訓練思路結合二次嘗試與反思蒸餾,令複雜任務表現提升最多 81%。
演進脈絡
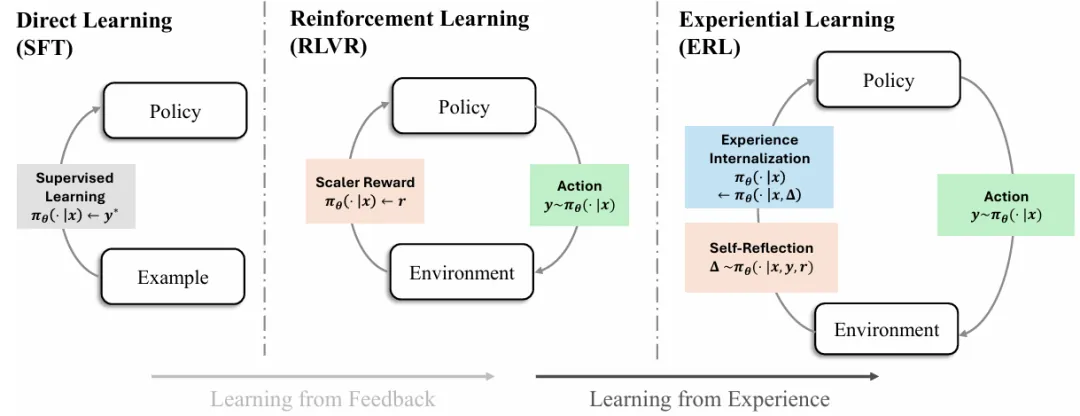
大模型的學習方式經歷清晰路徑:早期監督微調依賴固定示例模仿,受限於人工數據的規模與質量;隨後的可驗證獎勵強化學習將模型帶入交互環境,通過獎勵試錯優化策略,支持持續自我演進。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。