
 IXThinker·2026-03-10 21:30
30B開源模型跑通科研假設驗證閉環
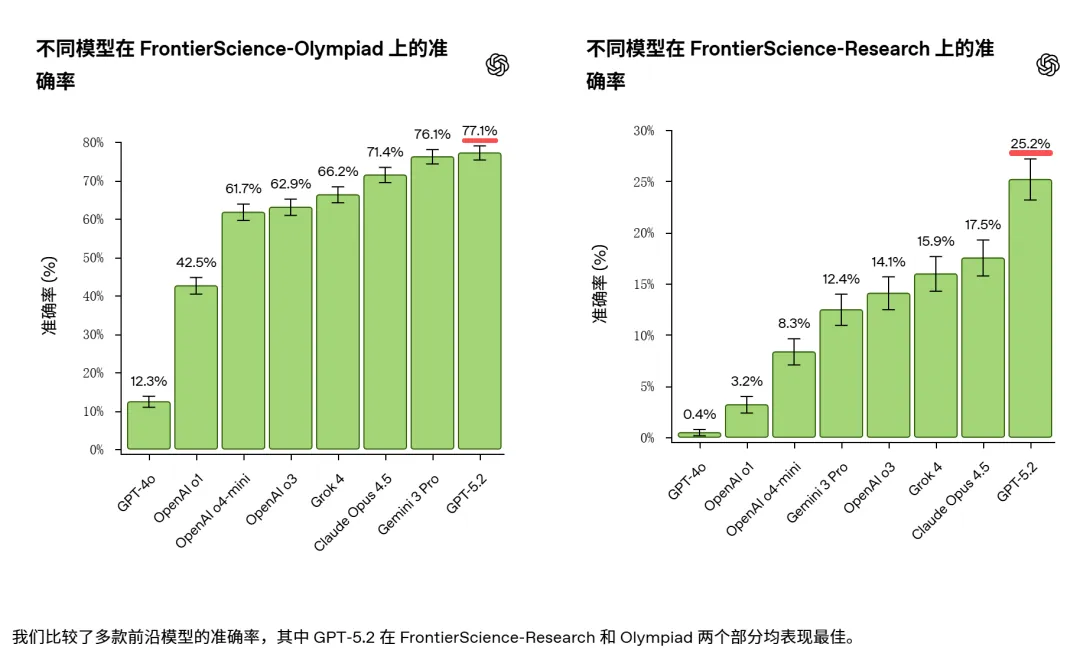
OpenAI去年底發布的FrontierScience基準顯示,大模型在奧賽級結構化題目表現尚可,但面對開放式科研任務成績驟降。一個僅30B參數的開源模型則跑通了假設、證據、驗證的科研閉環。
基準揭示
GPT-5.2在奧賽級結構化題目上取得77%,但開放式科研任務僅得25%,52個百分點的斷崖揭示真相:多數大模型擅長的是科研表演,引經據典、格式完美,一旦要提出假設、收集證據便力有不逮。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。