
 IXThinker·2026-03-10 15:50
RLAnything框架協同優化智能體訓練
芝加哥大學王胤杰將分享強化學習框架RLAnything:讓環境、策略與獎勵模型互相反饋、同步提升,從而增強訓練信號強度並優化整個系統,直指LLM與智能體RL系統的效能瓶頸。
框架設計
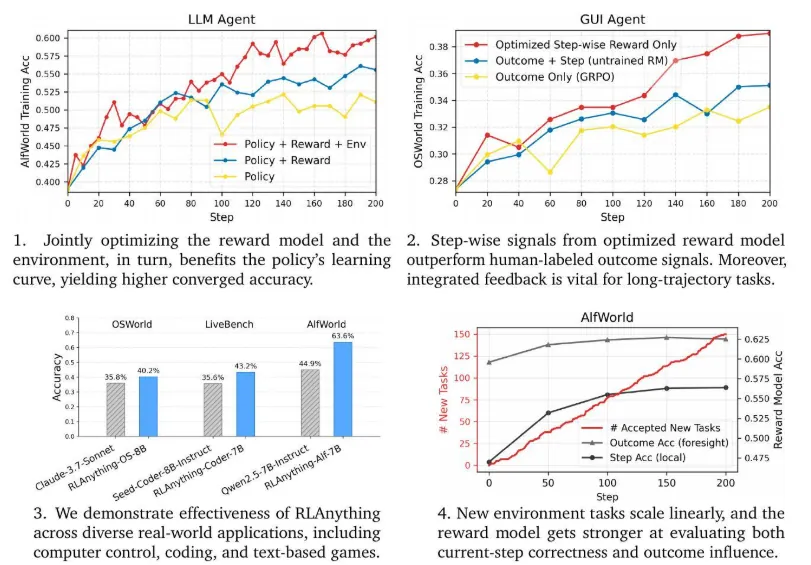
RLAnything的核心是讓環境、策略與獎勵模型三者雙向反饋。策略模型同時接收環境的最終驗證結果與獎勵模型的逐步獎勵,融合為統一的綜合型反饋,訓練信號因而更強、更穩。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。