
 IXThinker·2026-03-22 15:10
新基準BeyondSWE:頂尖模型通過率跌至45%
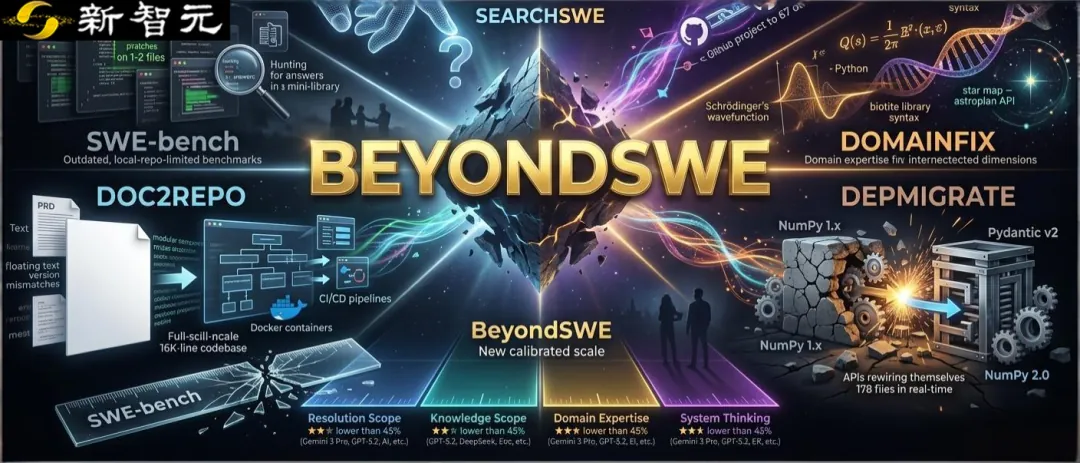
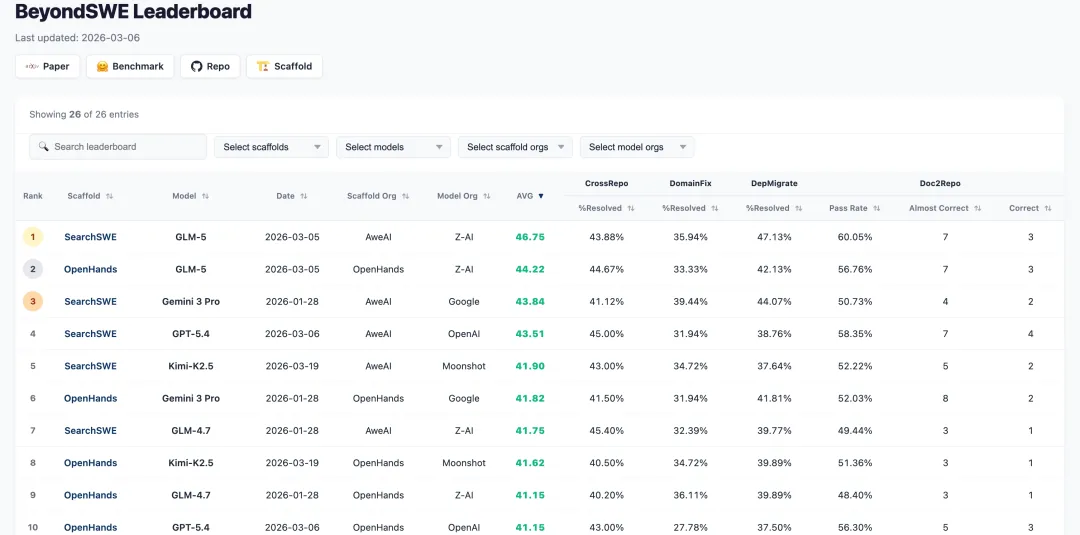
過去兩年SWE-bench幾乎是編程Agent的唯一標尺,前沿模型解決率已突破80%。新基準BeyondSWE卻顯示,真實工程能力遠未達標。
舊考卷失準
SWE-bench解決率從最初不足30%升至如今Gemini 3 Pro、GPT-5.2等模型突破80%,社區一度認為AI正逼近人類程式員水平。但審視考卷本身,任務多屬單倉庫小規模修改,難反映真實工程。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。