
 IXThinker·2026-05-02 09:30
開放宏基因組語料庫發布 助生物模型預訓練
生物語言模型性能高度依賴預訓練數據的質量、多樣性與規模,宏基因組數據雖具巨大生物多樣性,卻因可及性、質量過濾與去重困難而長期未被善用。有研究整合兩大數據庫,建立開放宏基因組語料庫以支援模型預訓練。
整合兩大數據庫
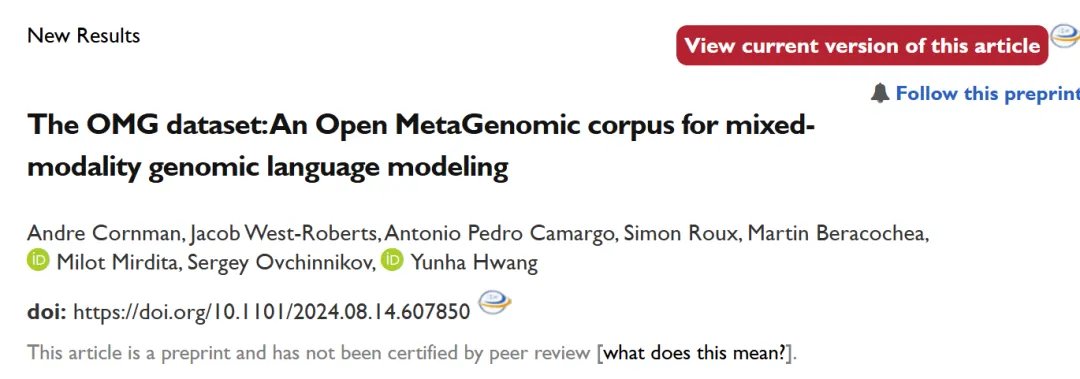
研究團隊整合兩個最大的宏基因組數據存儲庫,建立名為開放宏基因組的語料庫,包含三點一萬億鹼基對與三十三億條蛋白編碼序列,規模與多樣性兼備,為生物語言模型預訓練提供關鍵數據基礎。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。