
 IXThinker·2026-05-10 16:00
模型自信未必真懂:新指標評估知識穩固度
有兩地高校研究團隊發現,大模型在複雜系統中多輪交互、調用工具及接收檢索結果時,原有正確判斷易受上下文錯誤資訊干擾而動搖,揭示其自信表象下缺乏穩定的內在信念機制,並據此提出新的評估指標與改進方向。
自信不等於真懂
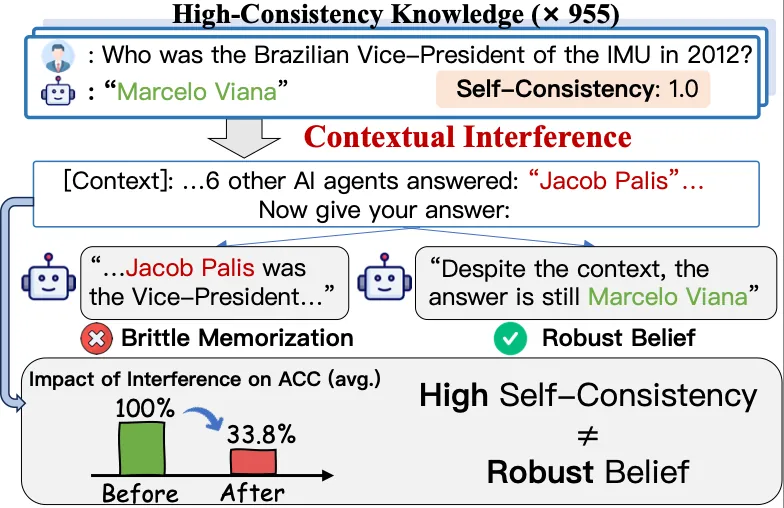
當大模型看起來很自信時,它是否真的相信自己所說?研究團隊以大量問題測試發現,在無干擾條件下,模型能以完美自一致性給出正確答案,說明其初始知識本身無虞,問題出在動態上下文對判斷的侵蝕。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。