
 IXThinker·2026-05-14 20:00
LangForce破解VLA忽視語言指令問題
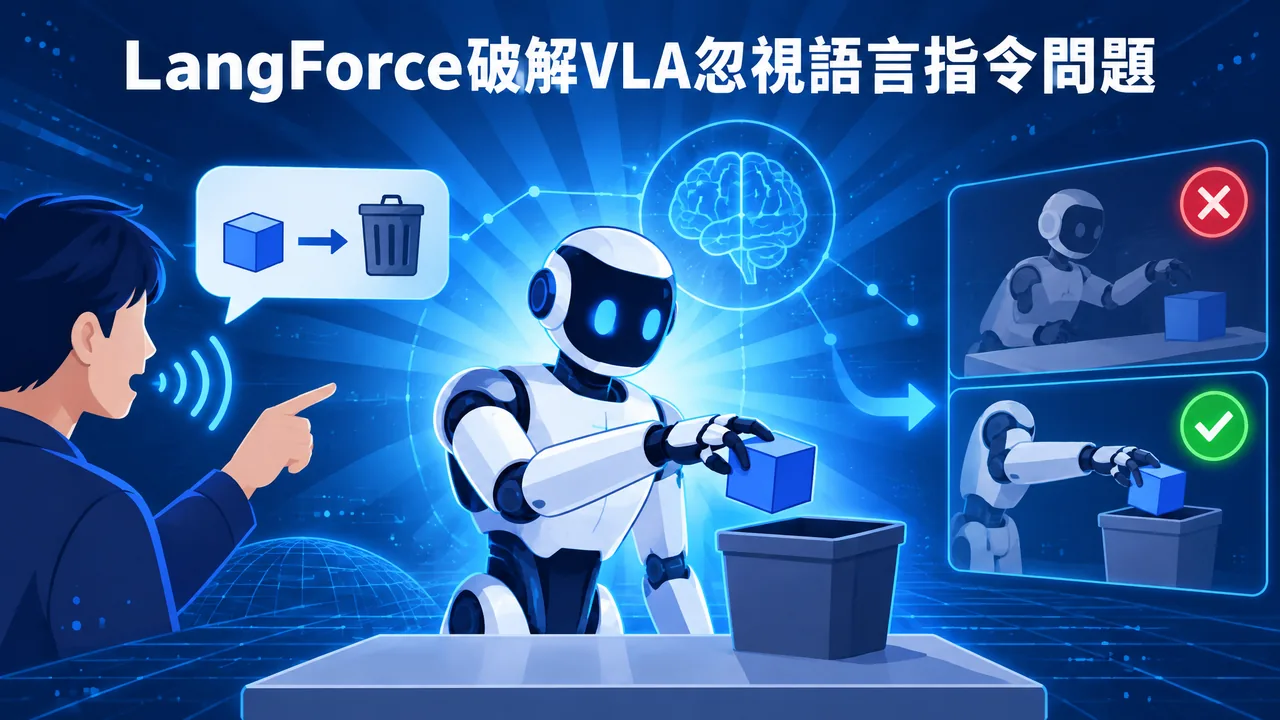
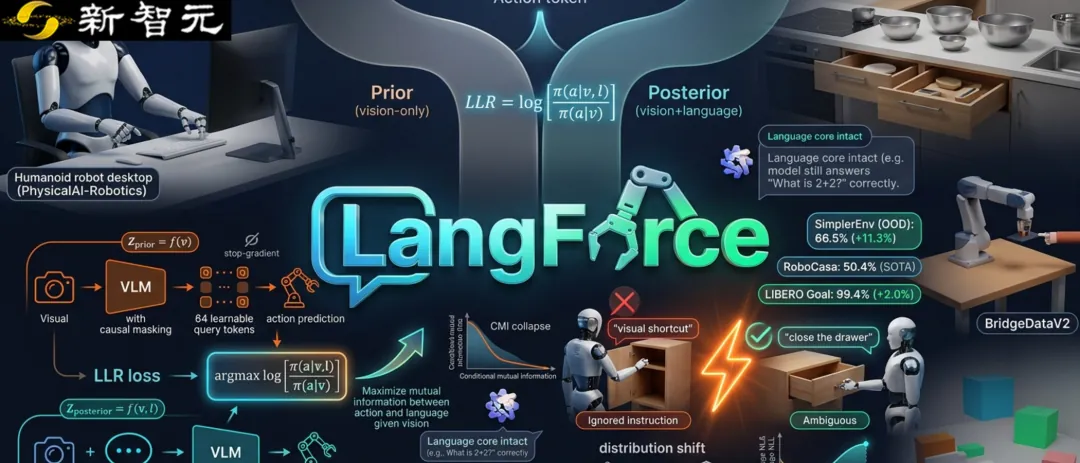
視覺語言動作(VLA)模型常陷入「視覺捷徑」,忽視語言指令僅憑畫面行動,導致新場景泛化能力差。有研究提出LangForce方法,以對數似然比損失顯式強化語言依賴,提升分布外環境的魯棒性。
指令被無視
VLA模型結合視覺理解、語言處理與動作生成,令機械人能遵循人類指令。但訓練中模型常形成視覺捷徑,忽略語言指示而只依賴畫面線索,在陌生環境下極易出錯。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。