
 IXThinker·2026-05-15 15:30
清華等團隊提出DYPO 融合監督微調與強化學習
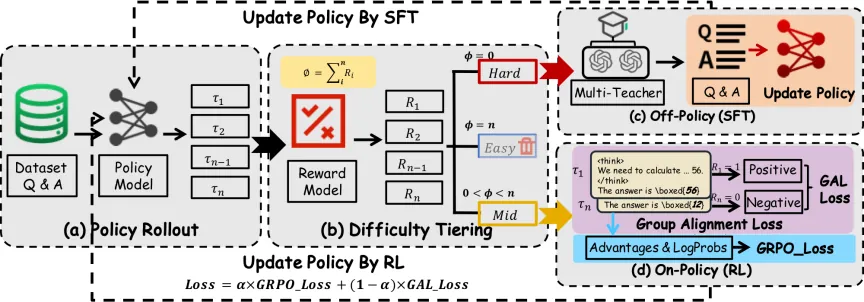
清華大學深圳國際研究生院聯同企業與院校團隊提出動態策略優化方法DYPO,直擊監督微調與強化學習信號難以融合的瓶頸,在保持訓練穩定的同時,統一提升大模型的複雜推理與分布外泛化能力。
兩種範式之爭
監督微調收斂快,能高效吸收高質量推理數據;強化學習更具探索性,有望推動複雜推理與泛化。但兩者學習信號統計性質天然不同,現有工作大多停留在把兩個損失混在一起的層面。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。