
 IXThinker·2026-06-11 18:10
智能體新基準面世,最強模型任務得分率不足一成
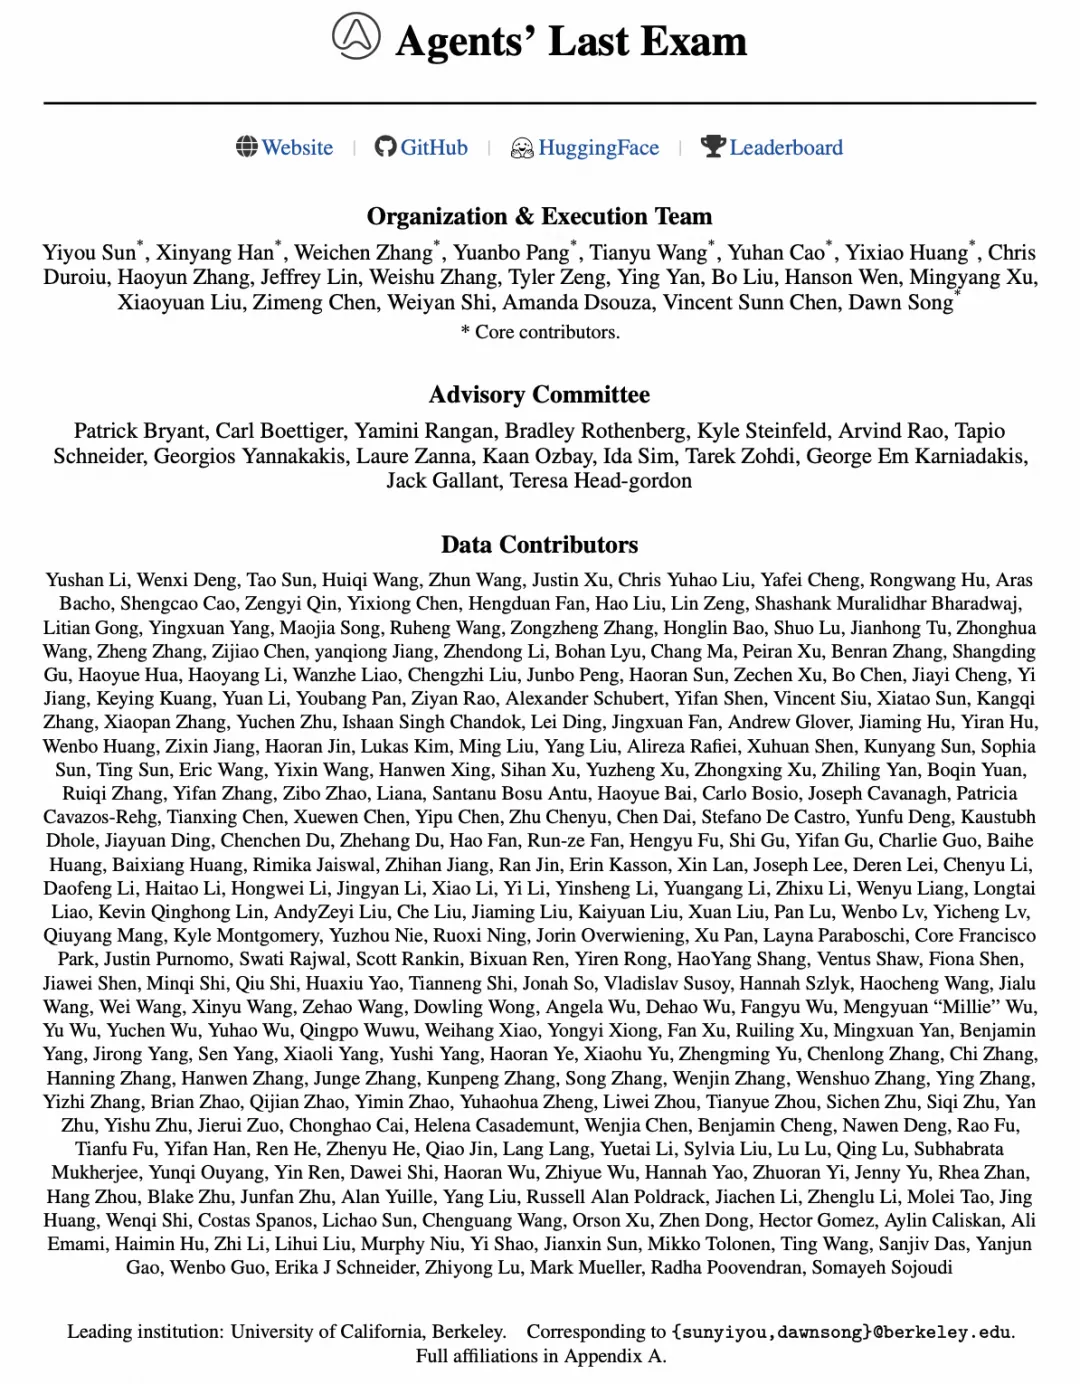
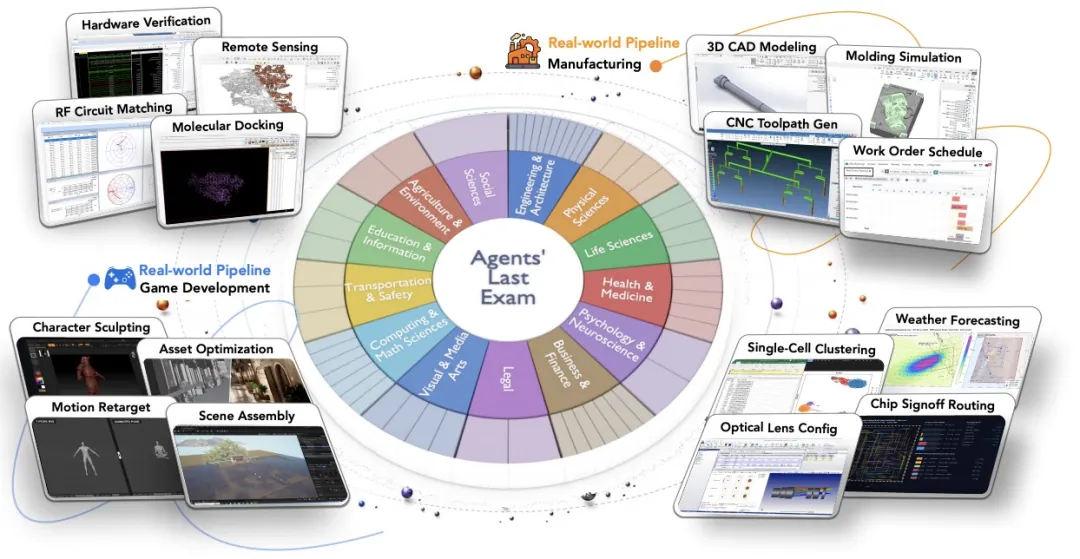
有研究指出,人工智能模型在棋類與主流基準測試屢創佳績,卻難以勝任真實、長流程的工作,問題並非能力不足,而在評估體系失效。由加州大學伯克利分校牽頭、逾250位專家參與,團隊提出新基準聚焦真實工作表現。
問題診斷
研究團隊認為,常用基準已無法持續衡量模型在真實、長流程且具經濟價值工作中的表現。模型縱使在考試式評測中屢破紀錄,也不等於能協助人類完成實際的專業任務。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。