
 IXThinker·2026-06-24 20:40
滑動窗口注意力破解長文檔解析
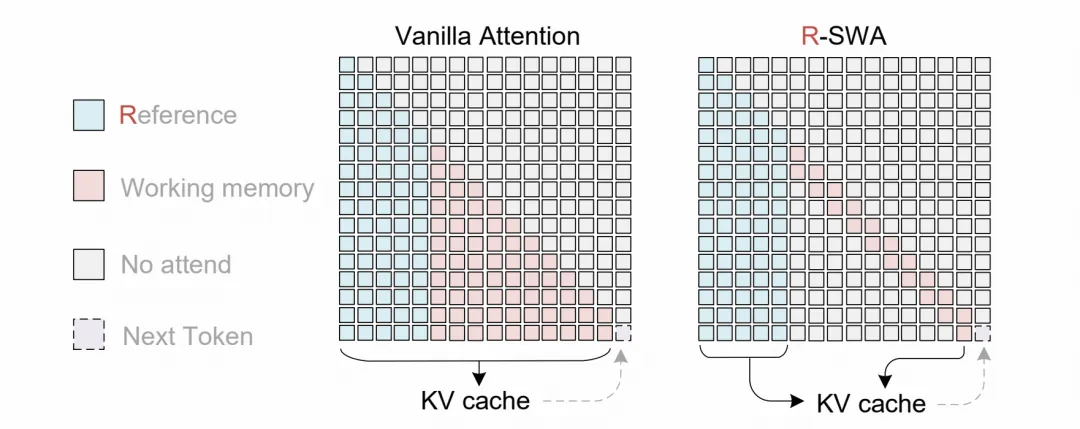
端到端文檔識別引入大語言模型解碼器後精度提升,但KV快取隨輸出增長持續膨脹,導致顯示記憶體佔用高、延遲遞增,主流逐頁處理方式實為工程補丁。新方法以參考滑動窗口注意力模仿人類軟遺忘,支援長文檔解析。
長文檔識別老大難
過去兩年,以大語言模型作解碼器的端到端OCR方案精度大增,但內在缺陷隨之暴露:輸出序列不斷增長時KV快取持續膨脹,既消耗大量顯示記憶體,又令每步解碼延遲逐漸拉長,長文檔處理成本高企。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。