
 IXThinker·2026-06-27 19:20
研究:避開對齊稅奧數準確率大升
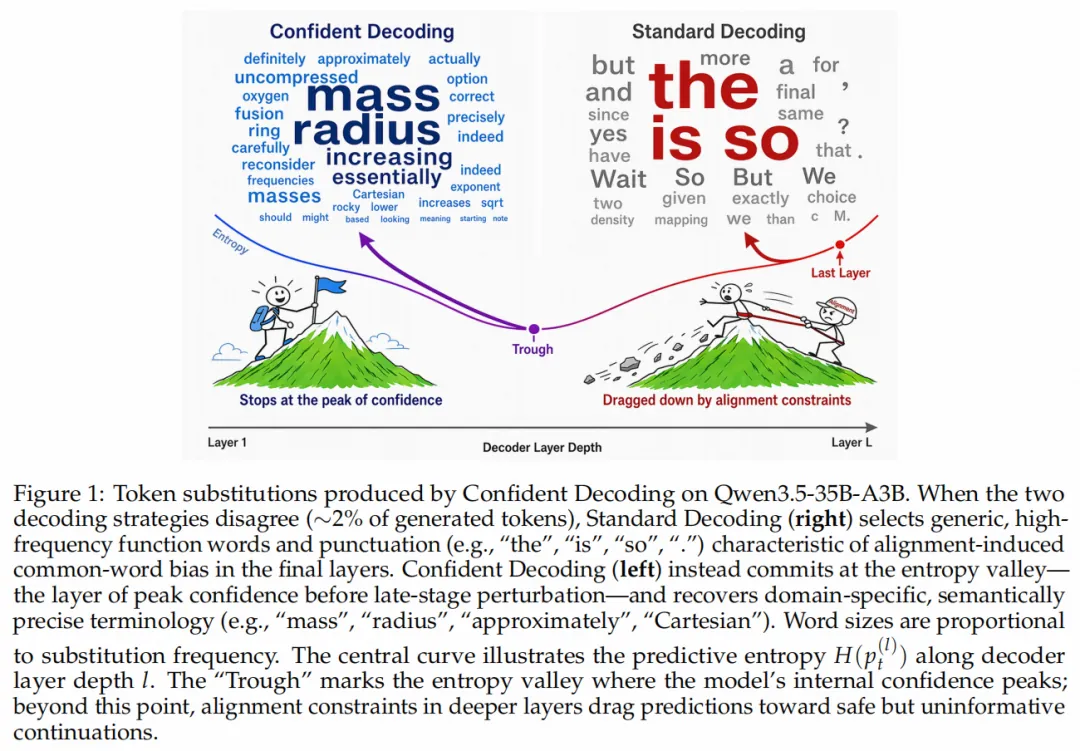
模型開發團隊聯合兩所大學發表研究,揭示大語言模型存在猜想、精煉、擾動的動態過程:中間層往往已蘊含最精準的推理語義,末層反受對齊訓練擾動拖累,繞開末層可大幅提升數學成績。
顛覆深度等於精度
傳統認知假定網絡越深,思考結果便越準確,各類開源自回歸模型也總是由最後一層輸出答案。新研究打破這一固有假設,發現推理精準度並非隨深度單調遞增,中間層反而可能已達最佳。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。