
 IXThinker·2026-07-02 10:00
智能體能否察言觀色 研究構建新測試
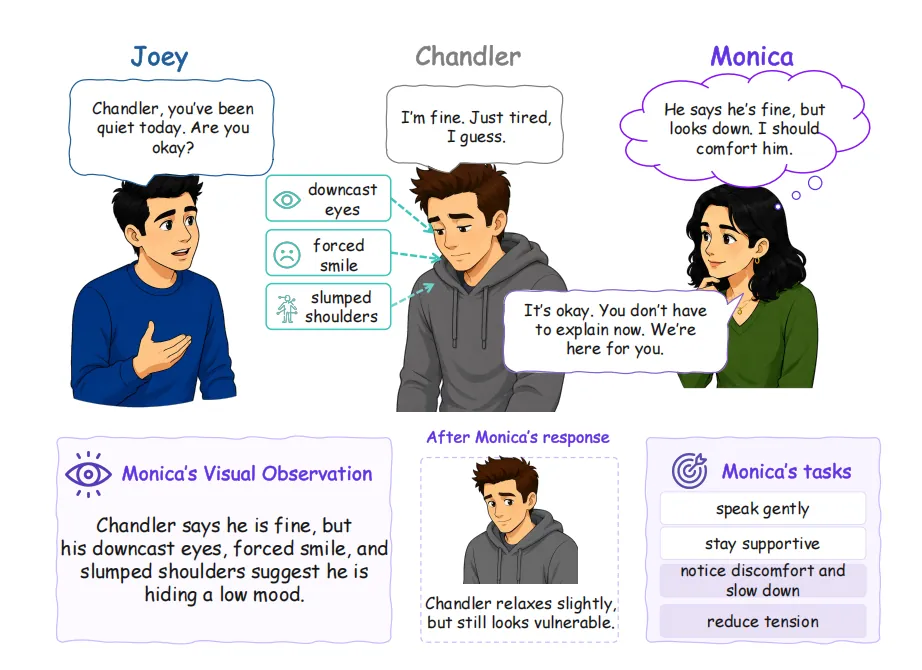
一句「我很好」,未必代表真的很好。人類會結合表情、姿態與語境作出判斷,智能體又能否做到?有研究團隊構建多模態基準AgentViSS,檢視智能體能否讀懂社交現場,把語言、視覺與行動整合成情境理解。
語言之外還有現場
人在社交中很少只憑字面理解對方。一句勉強的「我很好」,若配上低頭、垂肩與勉強的笑容,多半是在掩飾低落或迴避追問,此時合適的回應不是機械接受,而是放慢節奏、表達關心,或給對方留下空間。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。