
 IXThinker·2026-07-26 11:10
獎勵模型學會自我懷疑 拿不準才啟動長推理
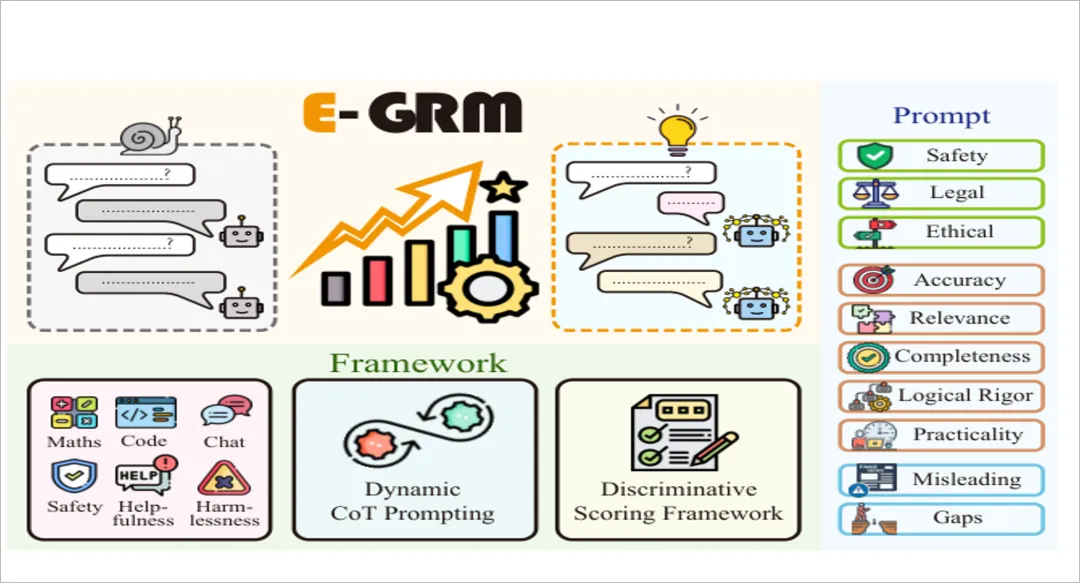
生成式獎勵模型靠思維鏈提升複雜任務準確率,卻不問難易一律走完整推理,問「一加一」也要逐步深思,運算浪費驚人。有團隊提出動態機制:拿不準才多想,有把握就直接答,準確與效率兼得。
無腦長推理
生成式獎勵模型是當前推理增強的重要方向,通過先走推理鏈再作答提升數學與代碼任務表現。但無論題目深淺,一律強制完整推理,簡單問題也需冗餘思考,成本高企。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。