
 IXThinker·2026-07-27 15:20
研究指SFT微調後一成半樣本屬「假學會」
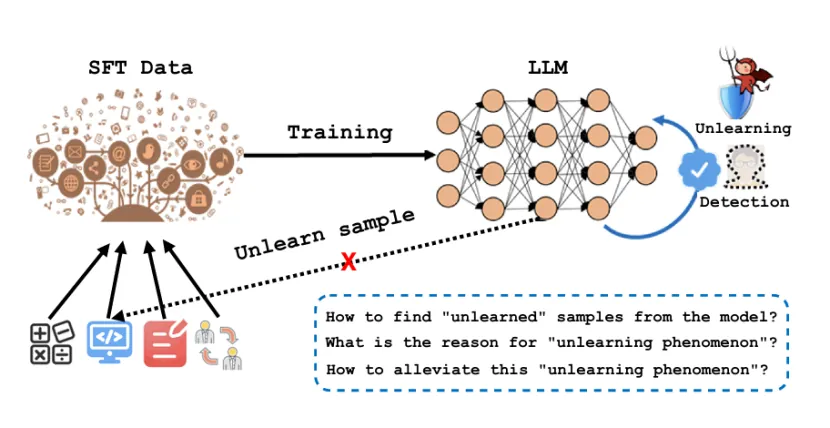
監督微調是大模型落地主流方案,但業界普遍默認訓練完成即等同學會。有研究對多個模型家族與任務全面排查,發現平均15.3%的訓練樣本屬「假學會」:損失已降,重測卻答不對。
微調的盲區
監督微調廣泛用於醫療問答、代碼生成、法律文書等領域適配,由千億大模型到端側小模型都在用。業界慣性假設訓練完就是學完,甚少關注後續持續學習能力。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。