
 IXThinker·2026-07-28 10:30
機械人自學聽聲辨位 毋須麥克風陣列與人工標註
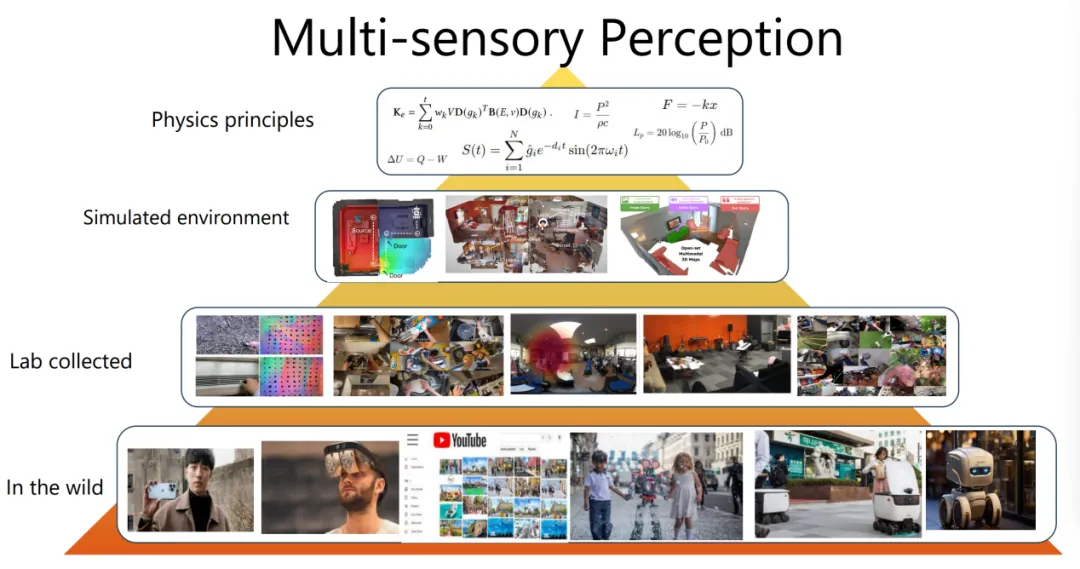
清華與密歇根大學團隊提出新方法:機械人只須觀看無標註的互聯網影片,結合相機自身運動,即可自學三維空間聽覺定位,毋須360度麥克風陣列與人工標註。核心洞察是相機自運動本身就是免費監督信號。
問題與舊路
讓機械人聽出聲音來自何方,過往須依賴昂貴的360度麥克風陣列採集數據,或以高昂人工標註構建訓練集,實驗室條件苛刻、成本高企,令空間聽覺感知難以規模化。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。