
 IXThinker·2026-08-11 17:00
超低延遲大模型推理 技術沙龍拆解軟硬協同
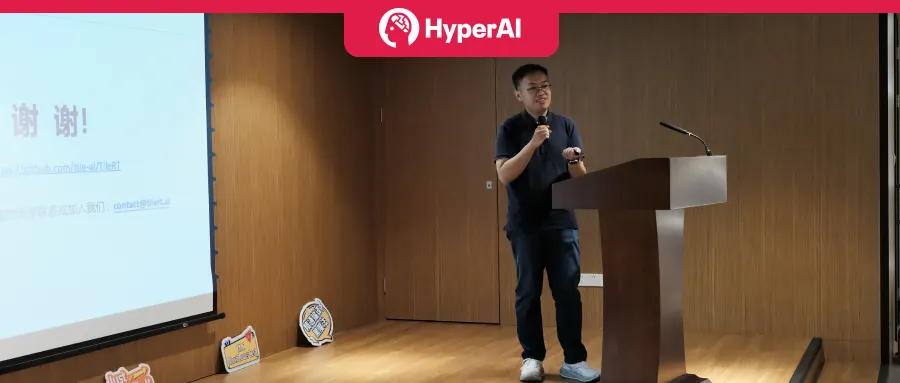
一場聚焦AI編譯的技術沙龍日前在北京舉行,超低延遲推理引擎團隊核心成員以速度即智能為題,分享大模型推理的計算優化與軟硬協同設計,多家企業與科研機構的系統專家到場交流,場面熱烈。
速度即智能
推理延遲直接影響大模型體驗與可用場景,TileRT團隊核心成員以超低延遲為目標,從計算優化與軟硬協同兩條主線入手,分享該引擎在低延遲推理領域的最新技術進展與工程實踐。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。