
 IXThinker·2026-08-18 13:30
大模型記憶機制綜述:走向顯式化
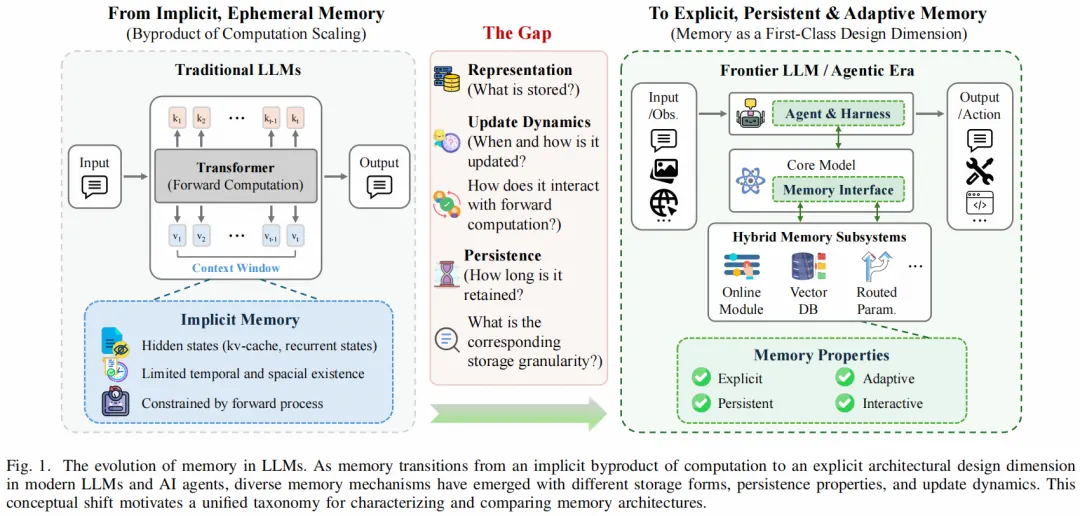
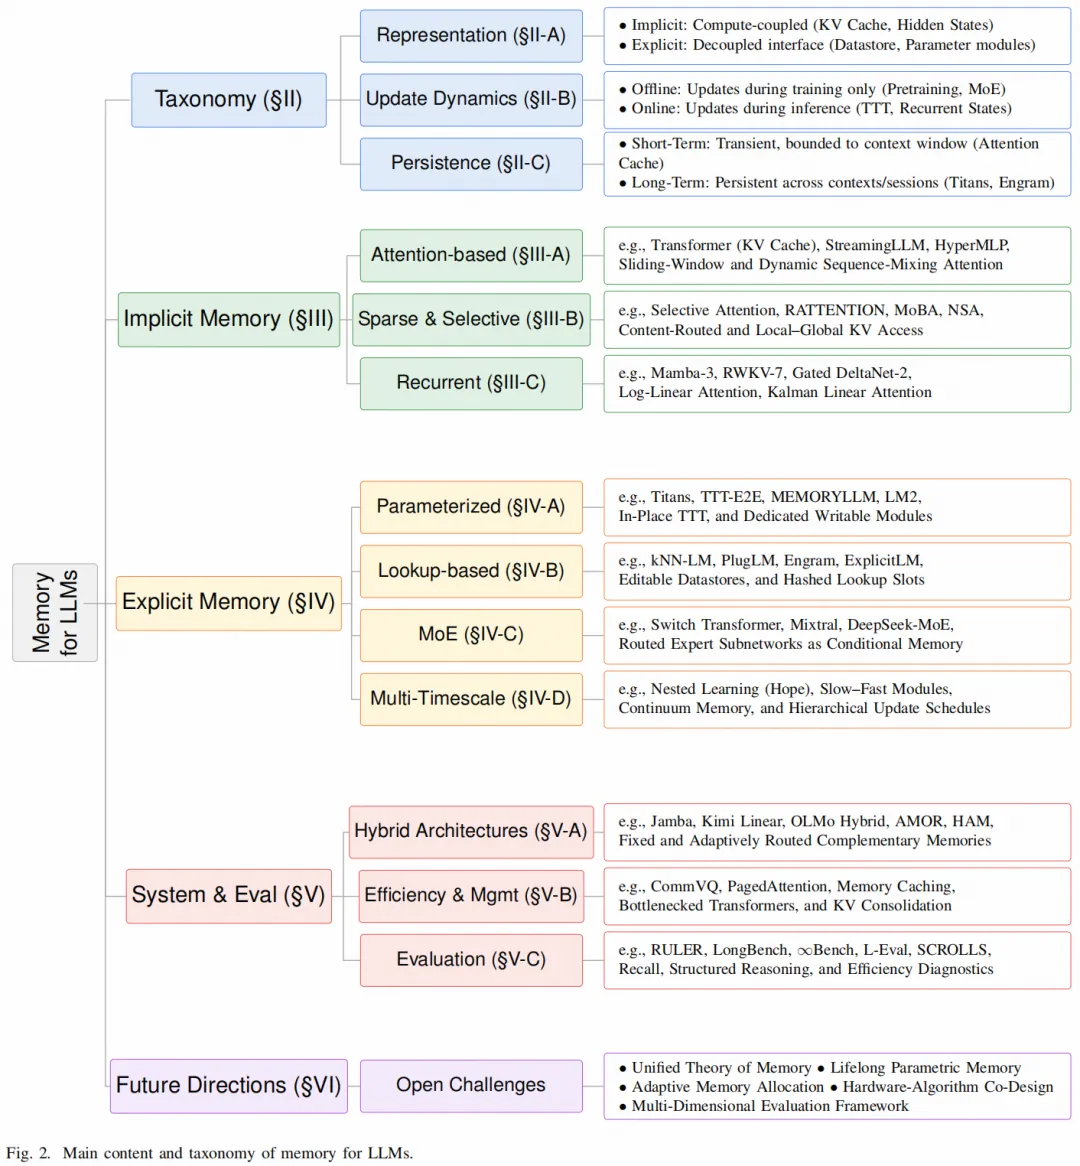
有大學聯合研究團隊發布大語言模型記憶機制綜述,指過往模型能力躍升主要歸功於規模法則,但記憶這一基礎架構維度正走向前台:傳統記憶隱式存在於前向計算中,顯式、持久且可操控的記憶機制成為新焦點。
規模法則之外
過去數年,大語言模型能力的躍升,很大程度被歸因於參數量、訓練數據與計算預算協同擴張的規模法則。然而隨着推理上下文不斷延長、長程任務湧現及智能體範式深化,一個同樣基礎的維度逐漸浮現:記憶。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。